 Grzegorz Adamczyk
Darmowy lektor AI po polsku, który działa na własnym komputerze i nie wymaga abonamentu, już jest. Zainstalowałem VoiceStudio, program, który w 30 dni zebrał na GitHubie prawie 49 tysięcy gwiazdek, i nagrałem nim cały krótki film. Najważniejsza rzecz wyszła przy czytaniu licencji: model, który program podsuwa na start, jest tylko do użytku niekomercyjnego. W tym samym programie jest drugi model, którego firma może używać. Pokazuję, jak je odróżnić, jak uruchomić ten właściwy, ile trwa nagranie bez karty graficznej i jak to brzmi.
Darmowy lektor AI z GitHuba: skąd ten program
Raz w miesiącu sprawdzam, które projekty na GitHubie rosły najszybciej, i jeden z nich testuję u siebie. Kandydatów biorę z miesięcznej listy GitHub Trending, a liczby z oficjalnego API GitHuba, bo strona i API potrafią się różnić. Okno: 12 października do 10 listopada 2026, odczyt 11 listopada.
| Miejsce | Projekt | Nowe gwiazdki w 30 dni |
|---|---|---|
| 1 | morluto/rea | 332 792 |
| 2 | debpalash/VoiceStudio | 48 888 |
| 3 | cloudflare/security-audit-skill | 41 477 |
| 4 | pingdotgg/t3code | 29 292 |
| 5 | pbakaus/impeccable | 28 299 |
Do testu wziąłem numer dwa. Lektora AI używam w każdym filmie i płacę za niego abonament (tak powstał na przykład film w tekście Claude Opus 5.5 w praktyce), więc pytanie „czy da się za darmo” jest dla mnie praktyczne. Numer jeden opisuję na końcu, ale go nie testowałem.
Co robi VoiceStudio
VoiceStudio to darmowy program z otwartym kodem (licencja AGPL-3.0), który uruchamiasz na własnym komputerze. Czyta tekst na głos, tworzy nowy głos z opisu słowami i klonuje głos z krótkiej próbki. Nagrania nie wychodzą do chmury.
Ważne jest to, czym VoiceStudio nie jest: to nie jeden lektor, tylko okno na wiele modeli różnych autorów. W wersji, którą testowałem (wydanie z 26 października 2026), rejestr programu wymienia 40 modeli. Każdy ma własną licencję. Program przypisuje im kategorie według tego, co podał wydawca modelu: przy 31 stoi „commercial”, przy 4 „noncommercial”, przy 5 status nieustalony. To podpowiedź, a nie gwarancja: dokumentacja licencji zastrzega, że żadnego modelu nie sprawdzono jeszcze do końca pod kątem użytku komercyjnego.
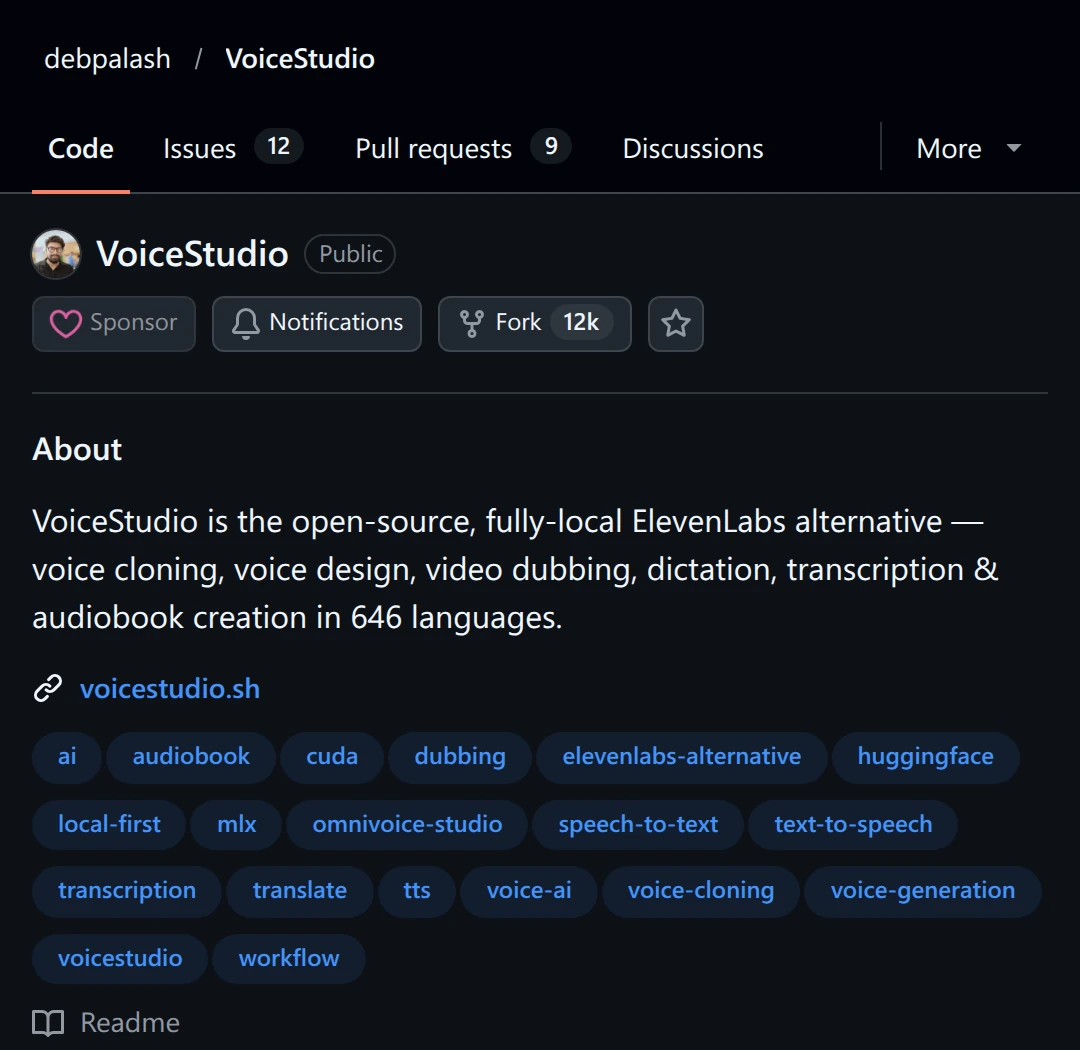
Sam program jest darmowy, także w firmie. Jego README dodaje jednak: „Model weights, voices and generated output have their own licences”. O tym, czy nagranie wolno wykorzystać komercyjnie, decyduje więc licencja modelu, którym je zrobisz.
Haczyk: model domyślny jest tylko do użytku niekomercyjnego
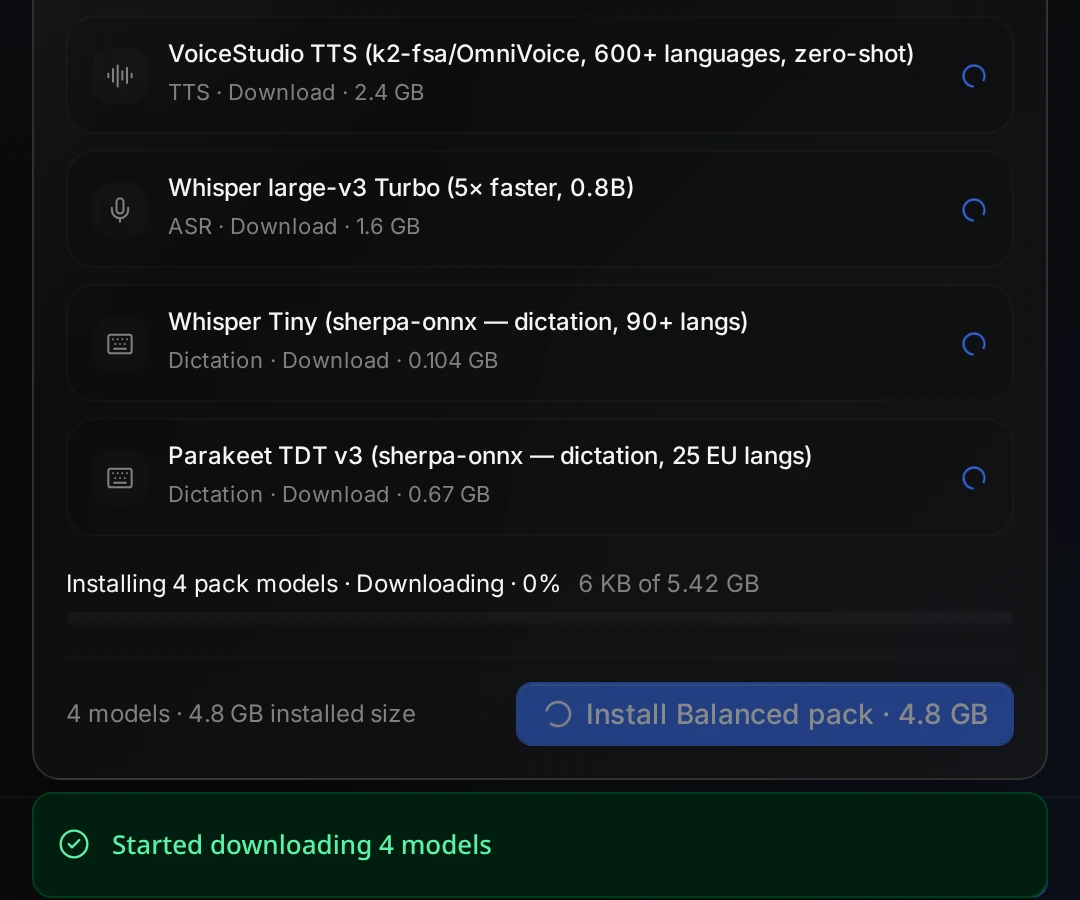
Model, od którego VoiceStudio zaczyna, nazywa się OmniVoice. W rejestrze programu jest oznaczony jako wymagany, a kreator pierwszego uruchomienia proponuje go w gotowej paczce.
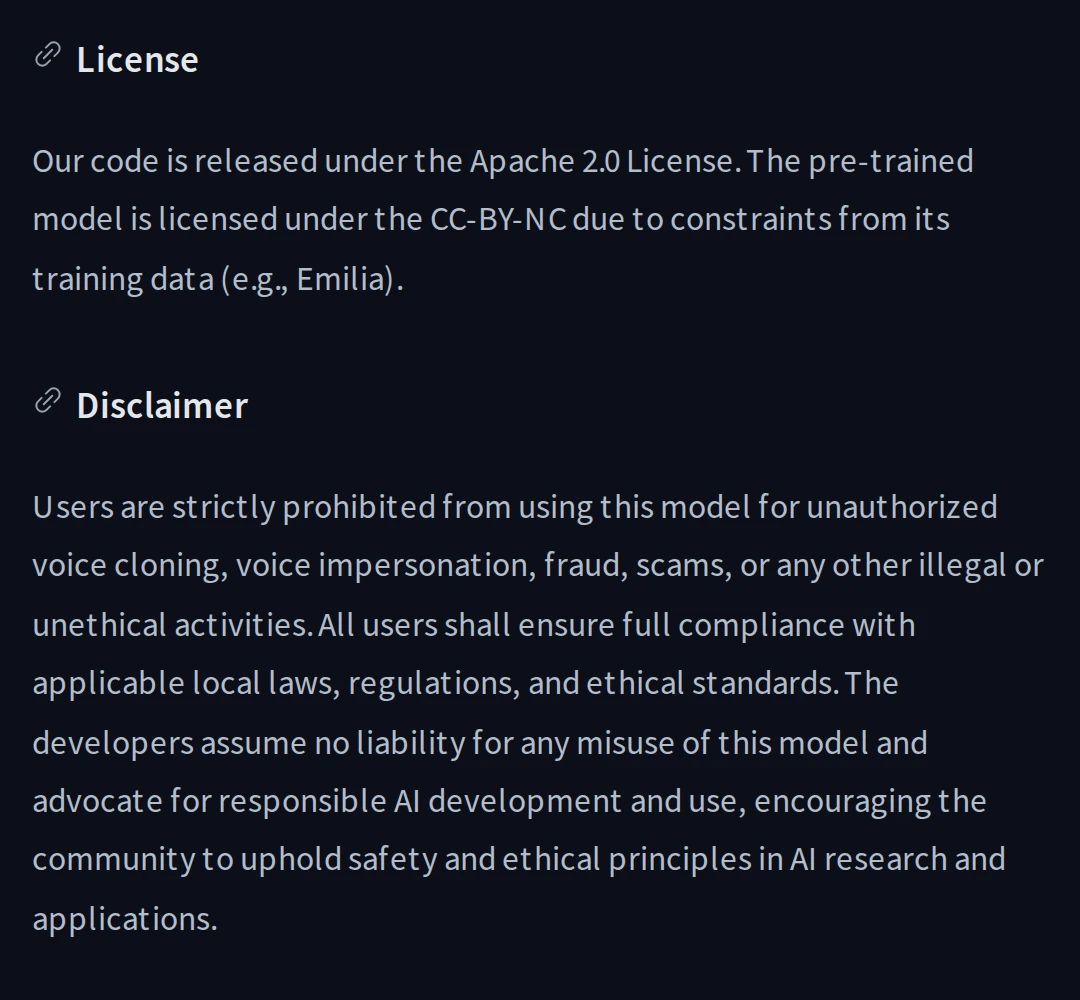
Na karcie modelu OmniVoice autorzy piszą:
„Our code is released under the Apache 2.0 License. The pre-trained model is licensed under the CC-BY-NC due to constraints from its training data (e.g., Emilia).”
Czyli kod jest wolny, ale wytrenowany model, a to on mówi, jest tylko do użytku niekomercyjnego. Powodem są dane, na których go uczono.
Program mówi to samo własnymi słowami. W szczegółach licencji tego modelu stoi kategoria noncommercial, a przy użyciu komercyjnym restricted.
Co znaczy „niekomercyjne”? Karta nie podaje wersji licencji, ale tekst CC BY-NC 4.0 definiuje to tak:
„NonCommercial means not primarily intended for or directed towards commercial advantage or monetary compensation.”
Po polsku: użycie, które nie służy przede wszystkim korzyści handlowej ani zarobkowi.
Liczy się cel konkretnego użycia, a nie to, kto używa. Creative Commons zaznacza, że sam fakt bycia firmą niczego nie przesądza. Film, który firma publikuje po to, żeby się promować, jest jednak nastawiony na korzyść handlową, nawet gdy sam nie zarabia. Dlatego bez dodatkowej zgody autorów nie nagrywam tym modelem niczego dla Fibon i jego licencji w programie nie zaakceptowałem.
Jest tu jeszcze jedna pułapka. Kreator pobiera ten model po kliknięciu „Install Balanced pack” i w tym miejscu nie pokazuje okna z licencją. Informacja o licencji jest w programie, ale w innym miejscu, w szczegółach modelu.
Model, którego firma może używać: VoxCPM2
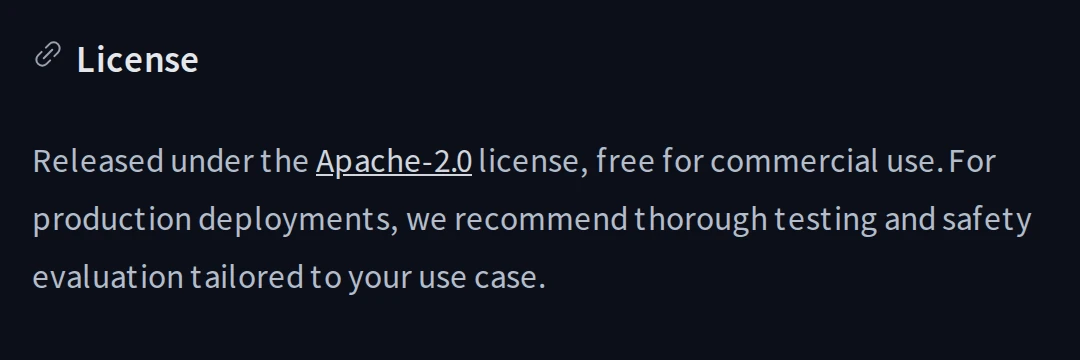
W tym samym programie jest VoxCPM2, model zespołu OpenBMB. Jego karta mówi wprost: „Released under the Apache-2.0 license, free for commercial use”. Apache 2.0 to jedna z najbardziej liberalnych licencji: pozwala używać modelu także w firmie. Opieram się tu na deklaracji autorów modelu. Dodają oni, że przed wdrożeniem produkcyjnym zalecają własne testy. Licencja modelu nie rozstrzyga też praw do cudzej próbki głosu ani licencji pozostałych składników programu.
Co potrafi według karty modelu:
- 30 języków, w tym polski. Języka nie trzeba wskazywać, wystarczy wpisać tekst.
- Głos z opisu słowami. Piszesz, kto ma mówić (płeć, wiek, ton, tempo), i dostajesz nowy głos bez żadnej próbki.
- Klonowanie z krótkiego nagrania, z możliwością zmiany stylu i emocji przy zachowaniu barwy.
- Dźwięk 48 kHz.
Tym modelem nagrałem cały minutowy film z tego testu. Każde zdanie czyta w nim darmowy głos:
Jak brzmi darmowy lektor AI po polsku: cztery głosy
Ten sam tekst kazałem przeczytać czterem głosom. Żadnego nie klonowałem z człowieka: każdy powstał z jednego zdania opisu, które widać na ekranie.
Moja ocena po odsłuchu: brzmi nieźle i do krótkiego filmu wystarczy. Posłuchaj i oceń samodzielnie, bo przy głosie każdy ma inny próg.
Emocje: ten sam głos, inna instrukcja
Sprawdziłem też, czy da się sterować emocją, tak jak w płatnych narzędziach. Da się, ale inaczej: emocję opisuje się instrukcją dla całej kwestii, a nie znacznikiem w środku zdania. Żeby barwa głosu została ta sama, podałem modelowi pierwszą próbkę jako nagranie wzorcowe i zmieniałem tylko instrukcję.
Ile trwa nagranie bez karty graficznej
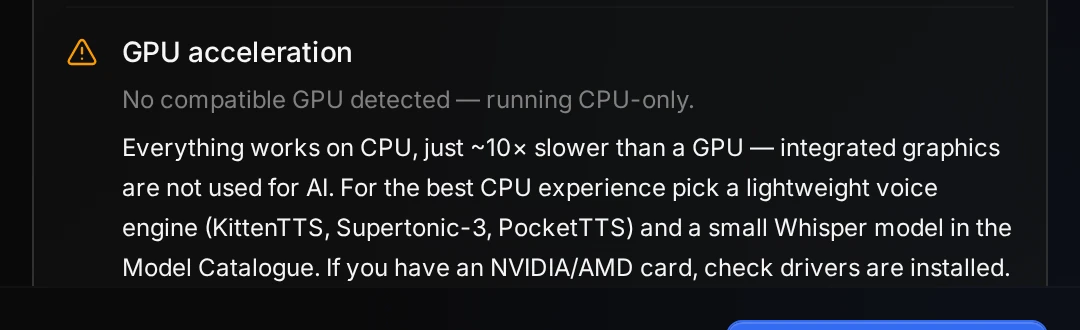
To jest główny koszt darmowego lektora. Na samym procesorze głos liczy się około dziesięć razy dłużej, niż trwa.
| Nagranie | Długość dźwięku | Czas liczenia |
|---|---|---|
| głos 1, młody mężczyzna | 12,4 s | 151 s |
| głos 2, młoda kobieta | 11,1 s | 104 s |
| głos 3, mężczyzna, niski głos | 13,8 s | 130 s |
| głos 4, kobieta, energicznie | 15,3 s | 135 s |
| kwestia z filmu, najdłuższa | 9,5 s | 94 s |
| kwestia z filmu, najkrótsza | 1,5 s | 18 s |
Minutowy film to u mnie około dziesięciu minut liczenia. Da się z tym żyć przy jednym shorcie, ale poprawianie pojedynczych zdań szybko robi się uciążliwe.
Z kartą graficzną ma być dużo szybciej. Autorzy modelu podają w karcie: „RTF as low as ~0.3 on NVIDIA RTX 4090”, czyli 10 sekund głosu w około 3 sekundy na bardzo mocnej karcie. Sam program przy starcie bez karty uprzedza: „Everything works on CPU, just ~10× slower than a GPU”. Na karcie graficznej tego nie mierzyłem.
Jak uruchomiłem VoxCPM2 w VoiceStudio
Test robiłem 11 listopada 2026 na VoiceStudio v0.5.7 (obraz stable z 26 października), na Ubuntu, na procesorze Ryzen 7 7800X3D, w Dockerze bez dostępu do karty graficznej. Obraz waży 11,2 GB, model VoxCPM2 kolejne 5 GB.
Uruchom program w Dockerze
Wygeneruj klucz i uruchom kontener poleceniem z dokumentacji projektu. Poczekaj, aż program zacznie odpowiadać pod adresem localhost:3900.
Pobierz sam model VoxCPM2
Pomiń kreator z gotowymi paczkami, bo paczka domyślna zawiera model niekomercyjny. Ja pobrałem jeden model wywołaniem API programu. To polecenie tylko zaczyna pobieranie w tle, więc poczekaj, aż status pokaże koniec.
Zrób dwie poprawki w kontenerze
Dopiero po zakończeniu pobierania. Program zgłaszał u mnie, że nie może wczytać modelu. Pomogły dwie komendy: nowsza biblioteka voxcpm i aktualizacja brotli. Potem restart kontenera, który przerwałby pobieranie, gdyby jeszcze trwało.
Nagraj pierwszą kwestię
Wyślij tekst, język i opis głosu. Po chwili dostajesz plik WAV.
Polecenia z mojego testu, w tej samej kolejności:
# 1. klucz i kontener (wersja bez karty graficznej, z dokumentacji projektu)
export OMNIVOICE_API_KEY="$(python3 -c 'import secrets; print(secrets.token_urlsafe(32))')"
docker run -d --name omnivoice \
  -p 127.0.0.1:3900:3900 \
  -e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" \
  -e OMNIVOICE_DATA_DIR=/app/omnivoice_data \
  -v omnivoice-data:/app/omnivoice_data \
  ghcr.io/debpalash/voicestudio:stable

# program jest gotowy, gdy to polecenie zwraca 200
curl -s -o /dev/null -w "%{http_code}\n" \
  -H "Authorization: Bearer $OMNIVOICE_API_KEY" http://127.0.0.1:3900/engines/tts

# 2. sam model VoxCPM2 (5 GB); polecenie tylko zaczyna pobieranie w tle
curl -H "Authorization: Bearer $OMNIVOICE_API_KEY" -H "Content-Type: application/json" \
  -d '{"repo_id":"openbmb/VoxCPM2"}' http://127.0.0.1:3900/models/install

# postęp pobierania; powtarzaj, aż się skończy
curl -H "Authorization: Bearer $OMNIVOICE_API_KEY" http://127.0.0.1:3900/models/install/status

# 3. dwie poprawki i restart (dopiero po zakończeniu pobierania)
docker exec omnivoice pip install "voxcpm>=2.0.3"   # u mnie weszła wersja 2.0.3
docker exec omnivoice pip install -U brotli          # u mnie 1.1.0 -> 1.2.1
docker restart omnivoice

# 4. pierwsze nagranie
curl -H "Authorization: Bearer $OMNIVOICE_API_KEY" \
  -F "engine=voxcpm2" -F "language=pl" \
  -F "text=Ten głos powstał na moim komputerze." \
  -F "instruct=young adult male, natural conversational tone" \
  -o probka.wav http://127.0.0.1:3900/generate
Dwie uwagi. Poprawki żyją w kontenerze, więc po jego usunięciu trzeba je powtórzyć. I to jest stan z 11 listopada i wersji 0.5.7: projekt zmienia się szybko (są już wydania testowe 0.5.8), więc w nowszym wydaniu te błędy mogą nie występować.
Czy to alternatywa dla ElevenLabs
VoiceStudio sam przedstawia się jako alternatywa dla ElevenLabs, więc porównałem je z płatnym lektorem, którego używam. Cennik i zasady z elevenlabs.io/pricing, odczyt 11 listopada 2026.
| VoiceStudio z VoxCPM2 | ElevenLabs Free | ElevenLabs Starter | |
|---|---|---|---|
| Cena | 0 zł, liczy własny komputer | 0 USD | 6 USD miesięcznie bez podatku |
| Użytek komercyjny | tak, według licencji modelu | nie | tak |
| Ile głosu | bez limitu, ogranicza czas liczenia | około 10 minut miesięcznie | około 30 minut miesięcznie |
| Gdzie trafia tekst | zostaje na komputerze | do chmury dostawcy | do chmury dostawcy |
Najciekawszy jest środkowy słupek. Darmowy plan płatnego lektora też nie jest do firmowych materiałów. Pomoc ElevenLabs pisze: „The free plan does not include a commercial license and cannot be used for any commercial purpose”. W moim porównaniu bezpłatną opcją z deklarowaną zgodą na zastosowania komercyjne okazał się więc VoxCPM2 uruchomiony lokalnie.
A jakość po polsku? Niezależnego testu nie znalazłem. Autorzy VoxCPM2 opublikowali własne porównanie i dla polskiego nie wypada ono jednostronnie. Płatny lektor ma niższy WER, czyli wskaźnik błędnie rozpoznanych słów: 0,766 wobec 1,141 (mniej znaczy lepiej). VoxCPM2 ma wyższy wynik podobieństwa głosu do próbki wzorcowej: 88,4 wobec 72,9. To pomiar autorów modelu, a nie pełna ocena naturalności.
Mój werdykt: do krótkich filmów da się, na co dzień zostaję przy płatnym. Powód to czas, nie jakość. Płatny lektor oddaje minutę głosu w kilka sekund i daje czasy pojedynczych słów, z których robię napisy. Tutaj czekam i napisy ustawiam po zdaniach.
Darmowy lektor ma sens, gdy nagrywasz rzadko, masz kartę graficzną albo nie chcesz wysyłać tekstów do cudzej chmury.
Klonowanie głosu: czyj głos wolno
VoxCPM2 klonuje głos z krótkiej próbki. To, że technicznie się da, nie znaczy, że wolno z każdym nagraniem. Głos jest dobrem osobistym, tak jak wizerunek, więc bezpieczne są dwa przypadki: własny głos albo głos osoby, która się na to zgodziła, najlepiej na piśmie i z opisem, do czego nagrania posłużą.
Twórcy narzędzi też to zaznaczają. README VoiceStudio: „Clone a voice only with its owner's permission”. Karta VoxCPM2: „Strictly forbidden to use for impersonation, fraud, or disinformation. AI-generated content should be clearly labeled”.
Z oznaczaniem program pomaga tylko w części: w jego logu widziałem, że do nagrań dodaje niewidoczny znak wodny. Taki znak czytają maszyny. Nie zastępuje jawnej informacji dla odbiorcy tam, gdzie wymagają jej przepisy. Kiedy tak jest, opisałem w tekście o AI Act w automatyzacjach.
W moim teście nikogo nie klonowałem. Głos powstał z opisu słowami, a „nagraniem wzorcowym” była moja własna pierwsza próbka z tego samego modelu.
Numer jeden na liście: REA
Pierwsze miejsce na liście, z przyrostem prawie siedem razy większym niż VoiceStudio, zajął REA, czyli „Reverse Engineer Anything”. Nie testowałem go. Opisuję go na podstawie dokumentacji projektu.
REA łączy agenta AI (na przykład Claude Code) z narzędziami do analizy gotowych programów. Autor opisuje to tak: widzisz w aplikacji funkcję, którą chcesz mieć u siebie, i prosisz agenta, żeby sprawdził, jak działa. Agent zagląda do programu bez kodu źródłowego, tłumaczy mechanizm, pokazuje dowody i pomaga zbudować własną wersję. Analiza działa lokalnie, projekt jest na licencji MIT.
To narzędzie dla osób technicznych, które budują własne oprogramowanie. Przy takim narzędziu od razu pojawia się pytanie, co wolno. Autor pisze, że REA służy do „lawful research, education, interoperability, software preservation, and analysis of software you own or are authorized to examine”.
W dokumencie z zastrzeżeniami dodaje, że projekt nie pomaga w „copying proprietary software or reproducing its protected code and assets”.
Polskie prawo autorskie rozróżnia tu trzy rzeczy:
- Podglądanie działania: wolno. Kto ma prawo korzystać z programu, może bez pytania producenta prowadzić „obserwowanie, badanie i testowanie funkcjonowania programu komputerowego w celu poznania jego idei i zasad” (art. 75 ust. 2 pkt 2). Same idee i zasady nie są chronione (art. 74 ust. 2), a umowa licencyjna nie może tego zakazać (art. 76).
- Rozkładanie kodu: tylko w wąskim celu. Dekompilacja jest dozwolona, gdy jest niezbędna, żeby Twój niezależny program mógł współdziałać z tamtym (art. 75 ust. 2 pkt 3).
- Kopiowanie: nie. Informacji z dekompilacji nie wolno użyć do zrobienia programu „o istotnie podobnej formie wyrażenia” (art. 75 ust. 3 pkt 3).
W praktyce: podpatrzeć, jak działa funkcja w programie, który legalnie masz, i napisać własną od zera, tak. Wyciągnąć z cudzego programu kod albo grafiki i wstawić do swojego, nie. REA potrafi jedno i drugie, więc granicy pilnujesz Ty, nie narzędzie.
REA podłącza się do agentów takich jak Claude Code. Jeśli dopiero je poznajesz, zacznij od prostszego rozszerzenia, czyli od hooków w Claude Code.
Najczęstsze pytania
Czy jest darmowy lektor AI po polsku do użytku komercyjnego?
Tak, według deklaracji autorów modelu. VoxCPM2 jest na licencji Apache 2.0, która pozwala na użytek komercyjny, i obsługuje polski. Uruchomiłem go w darmowym programie VoiceStudio. Uważaj na model domyślny tego programu (OmniVoice): jego wagi są na licencji niekomercyjnej.
Czy darmowy lektor AI działa bez karty graficznej?
Działa, ale wolno. U mnie na samym procesorze 10 sekund głosu liczyło się od 1,5 do 2 minut. Autorzy modelu podają, że na mocnej karcie graficznej głos powstaje szybciej, niż trwa.
Co znaczy licencja CC BY-NC przy modelu AI?
NC to skrót od NonCommercial. Modelu na takiej licencji nie wolno używać w sposób nastawiony przede wszystkim na korzyść handlową albo zarobek. Liczy się cel użycia: film albo reklama promująca firmę w tym się nie mieści.
Czy mogę sklonować swój głos za darmo?
Technicznie tak: VoxCPM2 klonuje głos z krótkiej próbki. Klonuj własny głos albo głos osoby, która wyraziła na to zgodę.