22 września 2026 Anthropic wypuścił Claude Opus 5.5. Dzień później otworzył dla wszystkich subskrybentów sesje Claude Code w chmurze i dorzucił do nich kredyty na start. Ja akurat miałem w szufladzie narzędzie, które od dawna chciałem zbudować porządnie. Zamiast czytać cudze testy nowego modelu, dałem mu prawdziwą robotę: jedna specyfikacja, dwa dni do startu na własnej domenie, trzeciego dnia wersja płatna. Ten tekst jest o tym, co z tego wyszło, ile kosztowało i w których miejscach musiałem wejść sam.
Z tego artykułu dowiesz się:
- Co zmienia Claude Opus 5.5 w cenie, szybkości i dostępności, jeśli nie piszesz kodu na co dzień
- Czym są sesje Claude Code w chmurze i kto dostał kredyty (kwoty, terminy, ograniczenia)
- Jak wyglądały dwa dni budowy narzędzia Shot Prep, etap po etapie
- Co się po drodze zepsuło i jak to wyszło na jaw
- Kiedy taki tryb pracy ma sens w Twojej firmie, a kiedy szkoda na niego czasu
Claude Opus 5.5: co realnie zmienia dla firmy, która nie pisze kodu
Najpierw skala. W ofercie Anthropic Opus to najwyższa półka modeli dostępnych w zwykłej subskrypcji. Ponad nim stoi Fable, model z segmentu dla najbardziej wymagających zastosowań. Trzy miesiące temu opisywałem Claude Sonnet 5, czyli środkową półkę. Opus 5.5 idzie piętro wyżej i robi dwie rzeczy naraz: podnosi jakość i obniża cenę.
Liczby pochodzą z ogłoszenia Anthropic z 22 września 2026.
| Co | Opus 5.5 | Skąd to wiadomo |
|---|---|---|
| Cena za milion tokenów | 4 USD za wejście, 20 USD za wyjście, czyli o 20 % mniej niż Opus 5; odczyt z pamięci podręcznej 0,20 USD, o 60 % mniej | ogłoszenie Anthropic |
| Koszt typowej pracy | według Anthropic o 40 % niżej niż na Opus 5 | ogłoszenie Anthropic |
| Szybkość | odpowiedzi ponad 30 % szybciej niż Opus 5 | ogłoszenie Anthropic |
| Poziom | „na poziomie Claude Fable 5.1 w większości zadań”, przewaga w kodowaniu agentowym, obsłudze komputera i pracy z wiedzą | ogłoszenie Anthropic |
| Gdzie działa | aplikacja Claude, Claude Code, Amazon Web Services, Google Cloud, Microsoft Azure; od 22 września także w Notionie | ogłoszenie Anthropic, wpis Notion |
| Co dalej | Sonnet 5.5 i Haiku 5.5 „w najbliższych tygodniach” | ogłoszenie Anthropic |
Dla Ciebie oznacza to trzy rzeczy:
- Plan Pro albo Max: najlepszy model Anthropic bez dopłaty, do tego podniesione limity w oknie pięciogodzinnym. Wybierasz model z listy i tyle.
- Automaty na API: ta sama praca kosztuje mniej. Te 40 % to liczba Anthropic dla ich typowego obciążenia, więc zmierz na własnym rachunku, zanim wpiszesz oszczędność do budżetu.
- Notion: nowy model wjeżdża do agenta, którego opisywałem przy okazji Notion 3.6. Najtańsza droga do sprawdzenia różnicy, bo nic nie instalujesz.
Cennik Opus 5.5 obok Opus 5
| Za milion tokenów | Opus 5.5 | Opus 5 |
|---|---|---|
| Wejście | 4 USD | 5 USD |
| Wyjście | 20 USD | 25 USD |
| Odczyt z pamięci podręcznej | 0,20 USD | 0,50 USD |
| Zapis do pamięci podręcznej | 5 USD | 6,25 USD |
Do tego tryb szybki w Claude Code i na Claude Platform: do 2,5 raza szybciej, za 8 USD za milion tokenów wejścia i 40 USD wyjścia, czyli dwa razy drożej niż zwykły Opus 5.5. Spadek kosztów o 40 % Anthropic tłumaczy dwiema rzeczami naraz: niższą ceną za token i mniejszą liczbą tokenów zużywanych na jedno zadanie.
Wyniki testów według Anthropic
Anthropic opublikował tabelę porównań z Fable 5.1, Opus 5 i dwoma modelami OpenAI. Przepisuję ją w całości, bo pokazuje też miejsca, w których Opus 5.5 nie wygrywa. Pogrubione są wyniki najlepsze w danym wierszu.
| Test (co mierzy) | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 (kodowanie agentowe) | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 (kodowanie agentowe) | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 (kodowanie agentowe) | 57,8 % | 51,8 % | 46,6 % | b.d. | 41,7 % |
| GDPval-AA v2.1 (praca z wiedzą, punkty) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench (procesy biznesowe) | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Humanity's Last Exam (rozumowanie, z narzędziami) | 67,7 % | 65,6 % | 63,6 % | 57,2 % | b.d. |
| Terminal-Bench-Science 0.1 (badania naukowe) | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0 (obsługa komputera, wynik częściowy) | 81,8 % | 80,7 % | 74,0 % | b.d. | b.d. |
| Chartography (odczyt wykresów, z narzędziami) | 89,0 % | 88,4 % | 83,4 % | b.d. | b.d. |
Trzy uwagi, zanim ktoś wklei tę tabelę do prezentacji. Po pierwsze, to wyniki producenta: liczby modeli OpenAI Anthropic podaje za OpenAI, a AutomationBench przeprowadził i opublikował Zapier. Po drugie, w dwóch wierszach wygrywa GPT-6 Astra: w procesach biznesowych i w badaniach naukowych. Po trzecie, Opus 5.5 był testowany z włączonymi zabezpieczeniami, a gdy zadziałały, część zadań z cyberbezpieczeństwa i biologii kończył starszy model, co według Anthropic prawdopodobnie zaniża jego wynik. Sam producent pisze zresztą wprost:
„That said, at these levels of capability we’ve found that benchmark margins have become a less reliable guide to real-world differences. In our own use, the gap between Opus 5.5 and Claude Fable 5.1 is narrower than these scores suggest.” (źródło)
Z tej tabeli dla firmy liczą się głównie trzy wiersze: praca z wiedzą (GDPval-AA), procesy biznesowe (AutomationBench) i obsługa komputera (OSWorld). W pierwszym i trzecim Opus 5.5 prowadzi, w drugim jest drugi, o 1,4 punktu. Reszty nie da się sprawdzić tabelką, więc sprawdziłem ją na własnym projekcie.
Czy Opus 5.5 pisze lepszy kod niż Opus 5? Nie mam testu porównawczego, mam jeden projekt na nowym modelu, więc to, co piszę niżej, jest obserwacją, nie pomiarem. Porównanie z Fable ma za to jedno konkretne źródło. Boris Cherny, twórca i szef Claude Code w Anthropic, napisał w dniu premiery:
„We had Opus 5.5 and Fable 5.1 each port HAProxy from C to Rust. Both passed nearly all of HAProxy's tests, but Opus 5.5 finished in 9.5 hours compared to Fable 5.1's 12 hours, and for 51% less cost.” (źródło)
To głos producenta, więc czytaj go jak głos producenta. Ale liczby są sprawdzalne w ich własnym repozytorium, a kierunek zgadza się z tym, co widziałem u siebie: szybko, bez zatrzymywania się w połowie zadania.
Sesje Claude Code w chmurze i kredyty: kto, ile, do kiedy
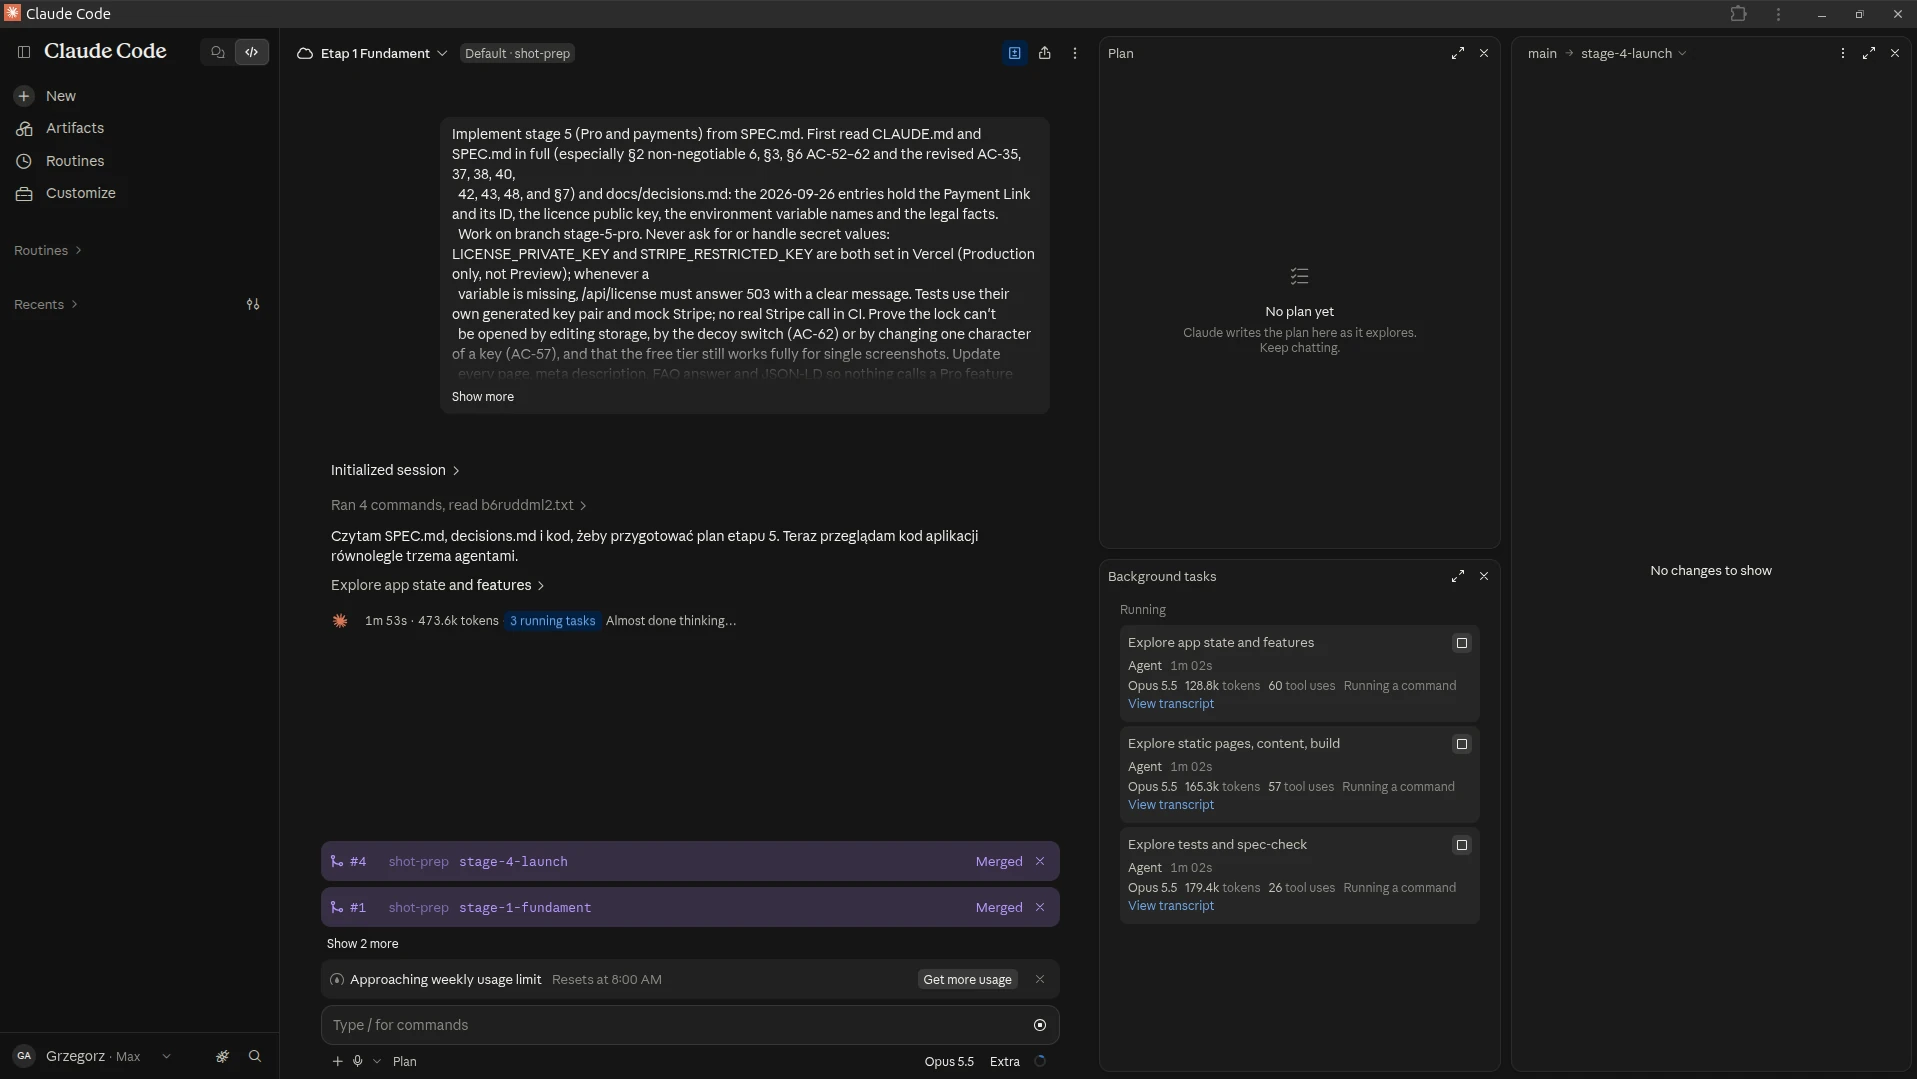
Claude Code to narzędzie Anthropic, które pracuje na repozytorium kodu: czyta pliki, pisze zmiany, uruchamia testy, robi commity. Do tej pory działało na Twoim komputerze. Sesja w chmurze robi to samo na serwerze Anthropic: wpisujesz zadanie w przeglądarce albo w telefonie, zamykasz laptop, a po jakimś czasie dostajesz gotową propozycję zmian do przejrzenia. Od 23 września 2026 to standardowa funkcja planów Pro, Max i Team, a nie eksperyment.
Razem z tym poszła promocja, i to ona ma datę ważności:
- Kwota: 100 USD dla planu Pro, 250 USD dla planu Max, jednorazowo.
- Kto: osoby, które miały aktywną subskrypcję 23 września, kiedy promocja ruszyła.
- Do kiedy odebrać: 7 października 2026, na stronie claude.ai/code/claim-credit albo komendą
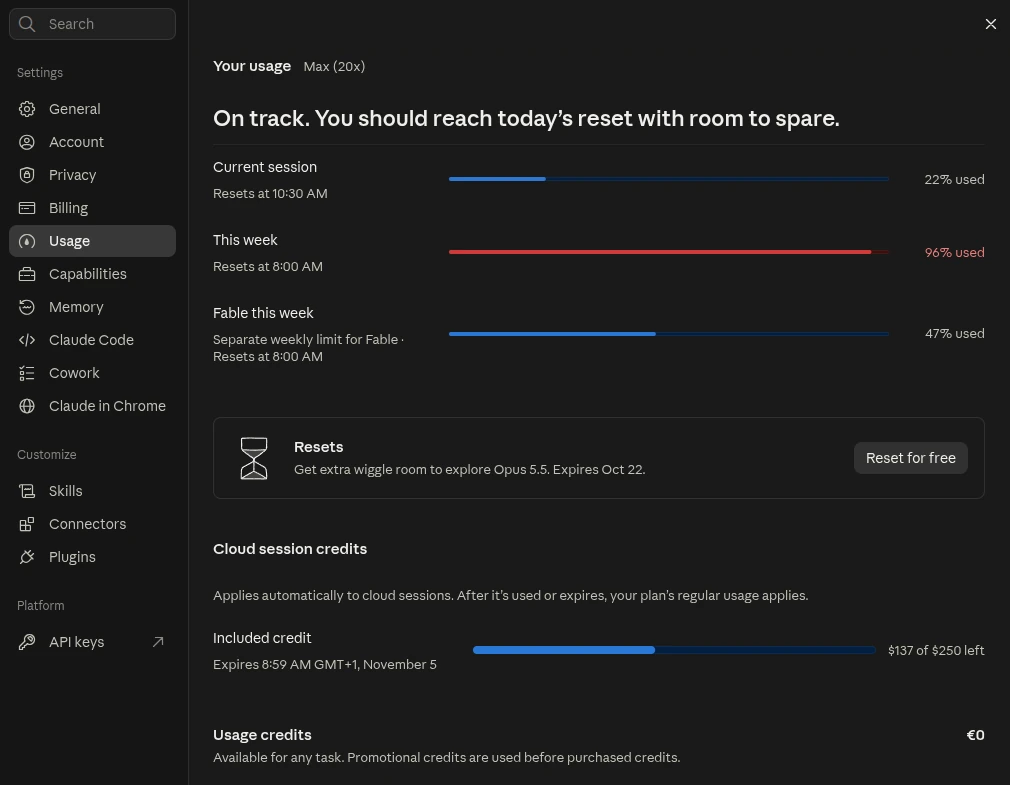
/claim-creditw Claude Code. - Do kiedy wykorzystać: 5 listopada 2026 rano (mój ekran pokazuje 8:59 czasu GMT+1). Reszta przepada.
- Na co: wyłącznie na sesje w chmurze. Nie na czat, nie na API, nie na Claude Code uruchamiany lokalnie.
- Co jest potrzebne: połączone konto GitHub, bo sesja klonuje repozytorium i odkłada tam swoje zmiany. Szczegóły promocji opisał BleepingComputer, a mechanikę sesji dokumentacja Claude Code. Dwie rzeczy z tej dokumentacji warto znać, zanim klikniesz: sama maszyna w chmurze nie kosztuje osobno, a po wyczerpaniu kredytu sesje wracają do zwykłego limitu Twojego planu. U mnie po pięciu etapach budowy licznik wyglądał tak:
Co zbudowałem: Shot Prep
Do artykułów takich jak ten robię dziesiątki zrzutów ekranu. Poprzedni tekst z dziennika budowy, o generowaniu artykułów w Notionie, miał ich czternaście. Każdy trzeba skadrować do stałego rozmiaru, odchudzić i czasem zamazać dane. Do tej pory robiłem to jednym plikiem HTML, który trzymałem na dysku i o którym nikt poza mną nie wiedział.
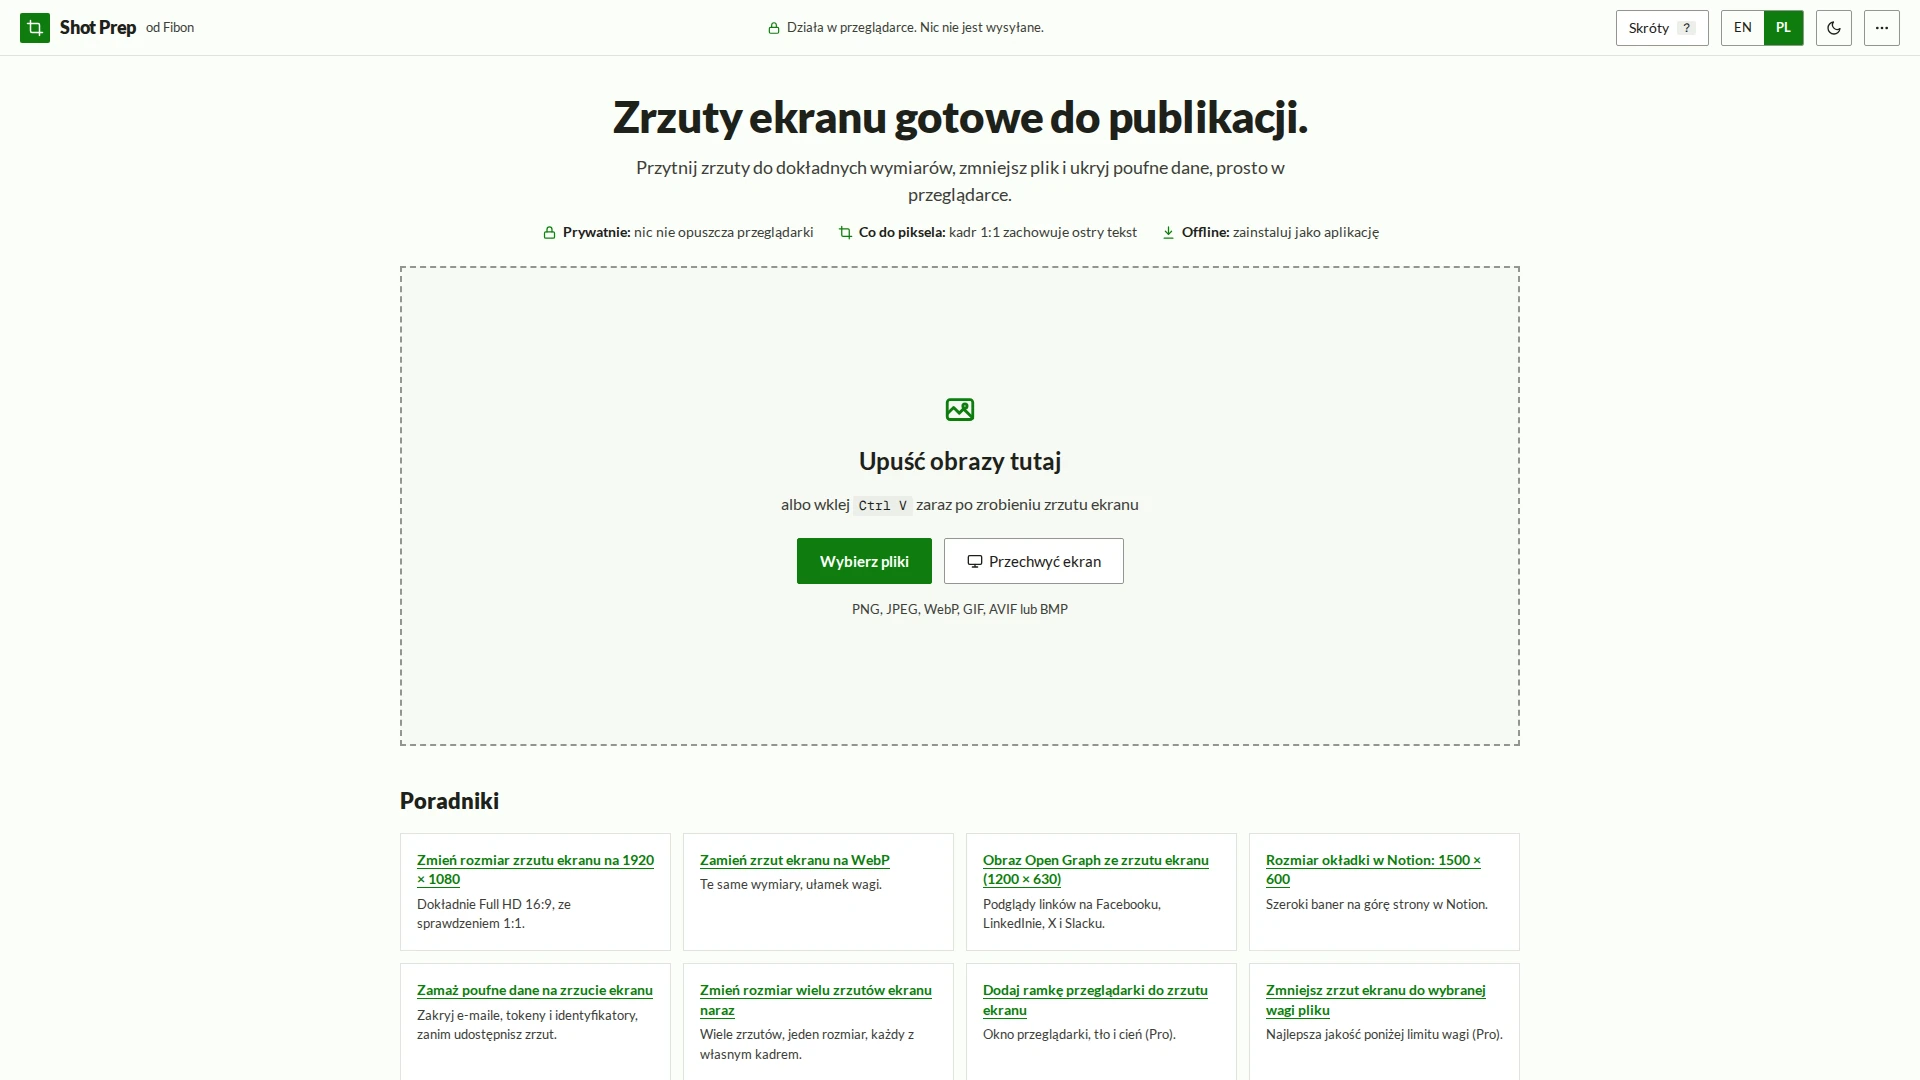
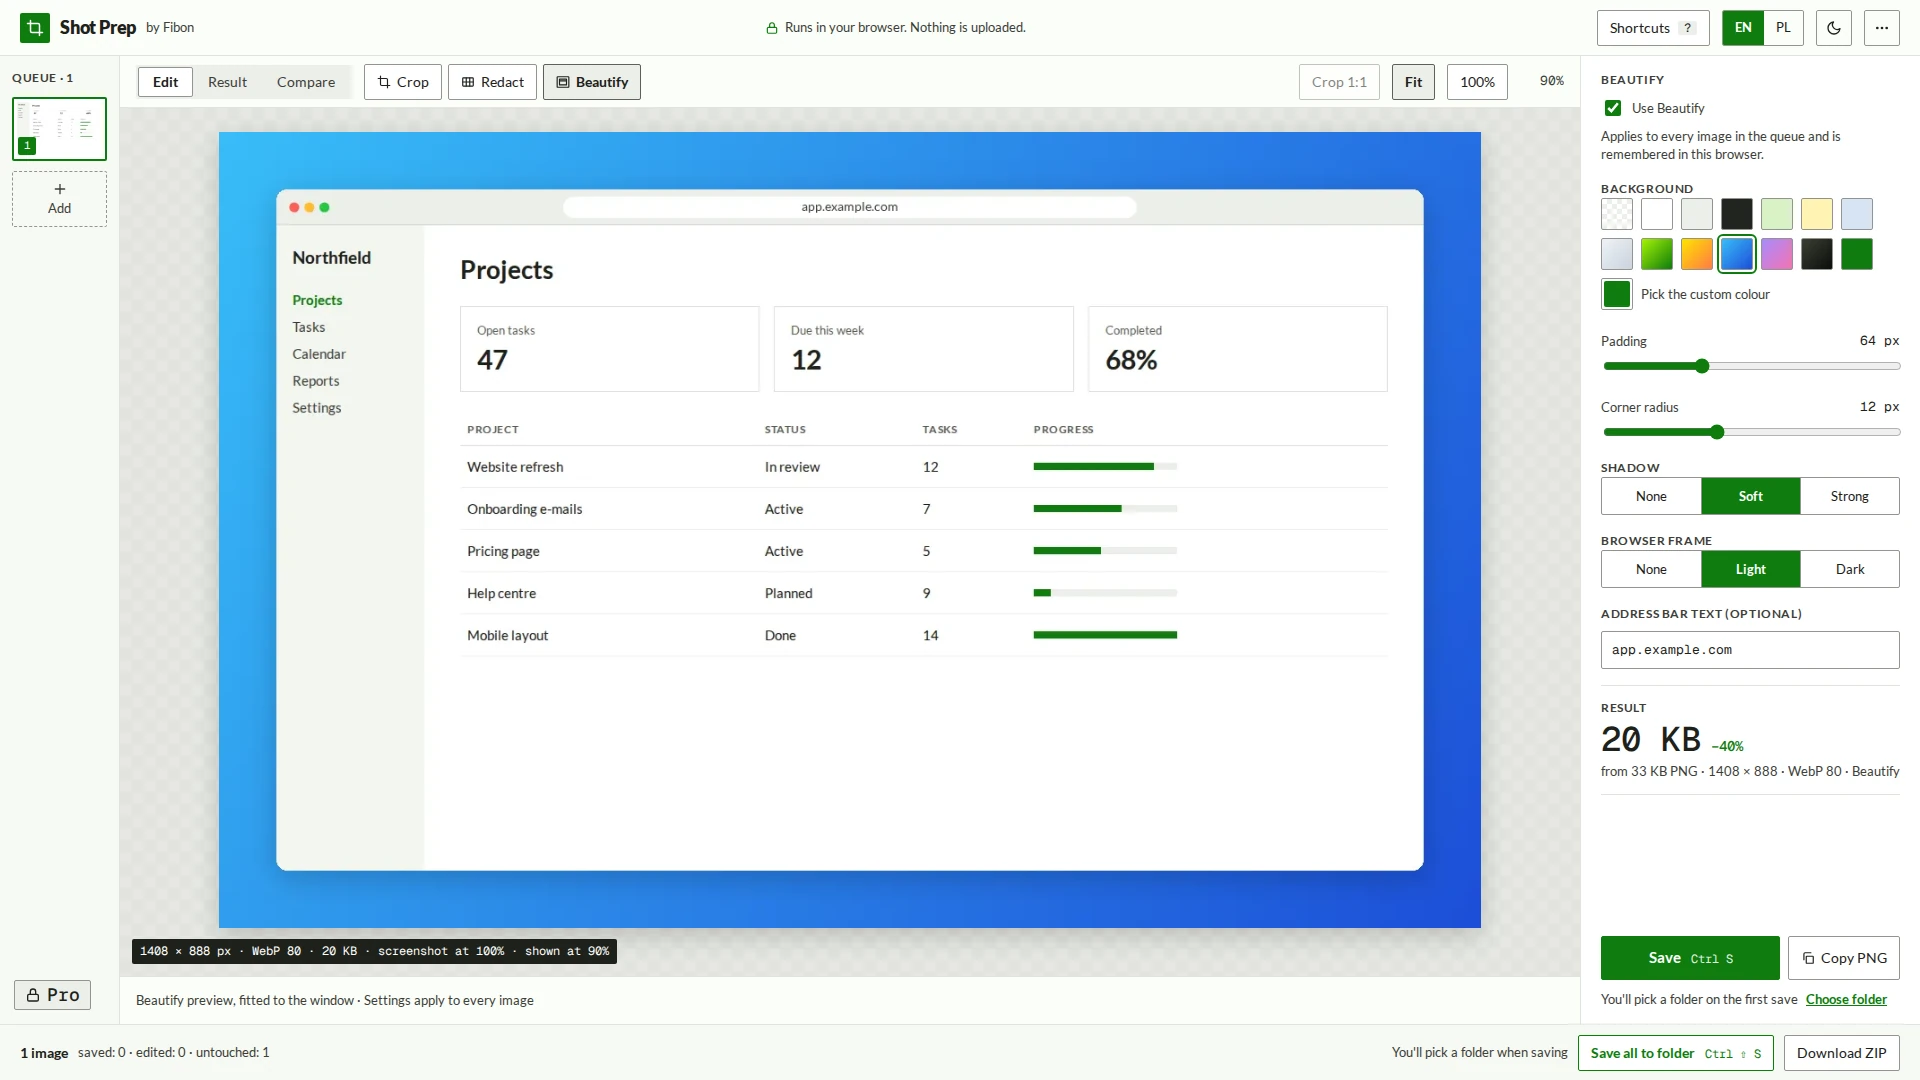
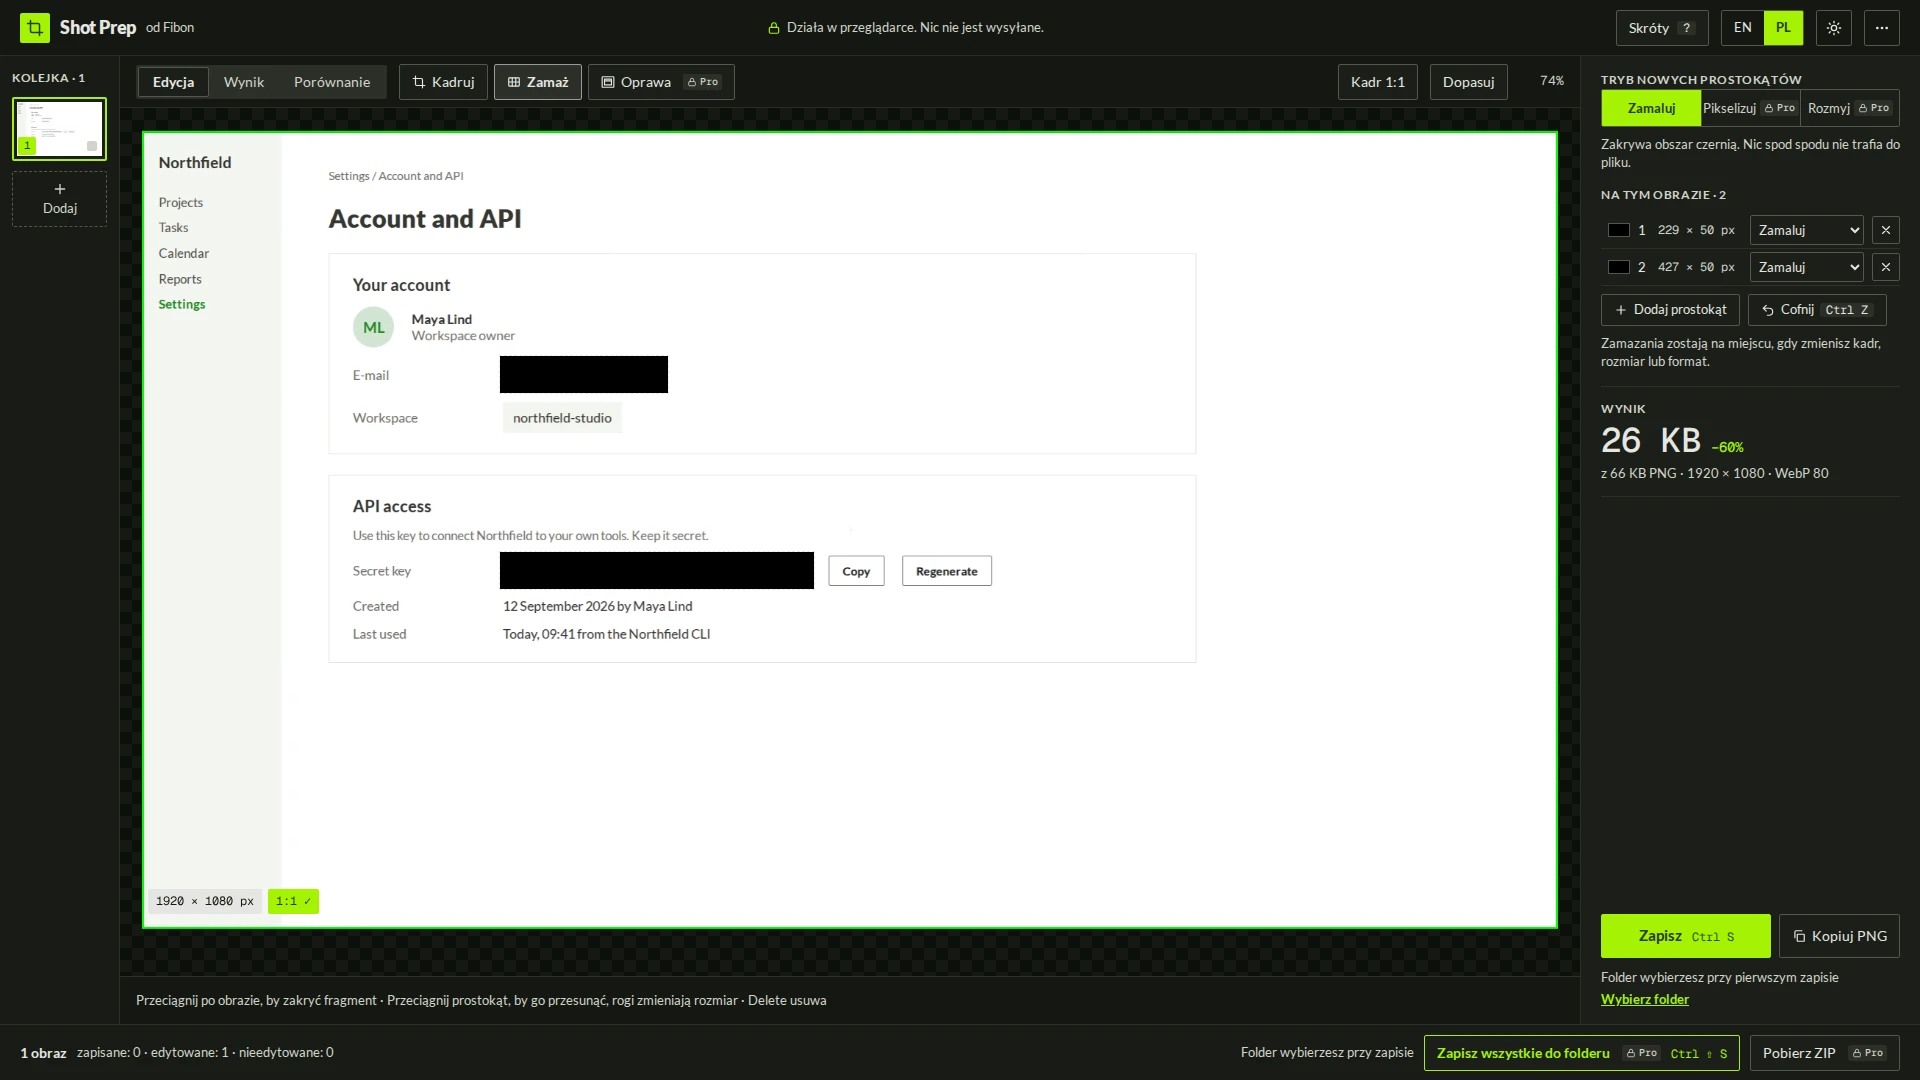
Shot Prep to ten sam pomysł zbudowany porządnie, pod adresem tools.fibon.pl/shot-prep. Wklejasz albo przeciągasz zrzuty, wybierasz rozmiar z listy (w tym rozmiary pod Notion i pod kartę linku w social mediach), kadrujesz, widzisz wagę pliku na żywo, zamazujesz hasła i dane klientów, zapisujesz albo kopiujesz do schowka. Wersja darmowa obsługuje pojedyncze zrzuty (do trzech w kolejce), wszystkie rozmiary, WebP, PNG i JPEG z suwakiem jakości, porównanie przed i po, zamazywanie czarnym prostokątem i pracę offline. Pro za 9,99 USD jednorazowo, z podatkiem w cenie, dokłada kolejkę bez limitu, zapis hurtem i ZIP, wzorzec nazw plików, AVIF, własne rozmiary, pikselizację i rozmycie, oprawę zrzutu (tło, ramka przeglądarki, cień) i docelową wagę pliku. Nic nie wychodzi z przeglądarki: nie ma serwera, który przetwarza obrazy, nie ma konta. Zapisane pliki nie niosą położenia ani danych aparatu z oryginału, co też sprawdzają testy. Jedyny kod po stronie serwera wydaje klucz licencji po zakupie i nie dostaje obrazów. Wersja angielska jest domyślna, polska ma własny adres.
Całość w 34 sekundach, z dźwiękiem. Film też powstał w kodzie, w Remotion, z lektorem i muzyką z ElevenLabs, a liczby na ekranie pochodzą z prawdziwej aplikacji.
Zrzuty ekranu w tym artykule przeszły przez Shot Prep. To pierwszy realny użytek z narzędzia, które opisuje.
Dwa dni do startu, etap po etapie
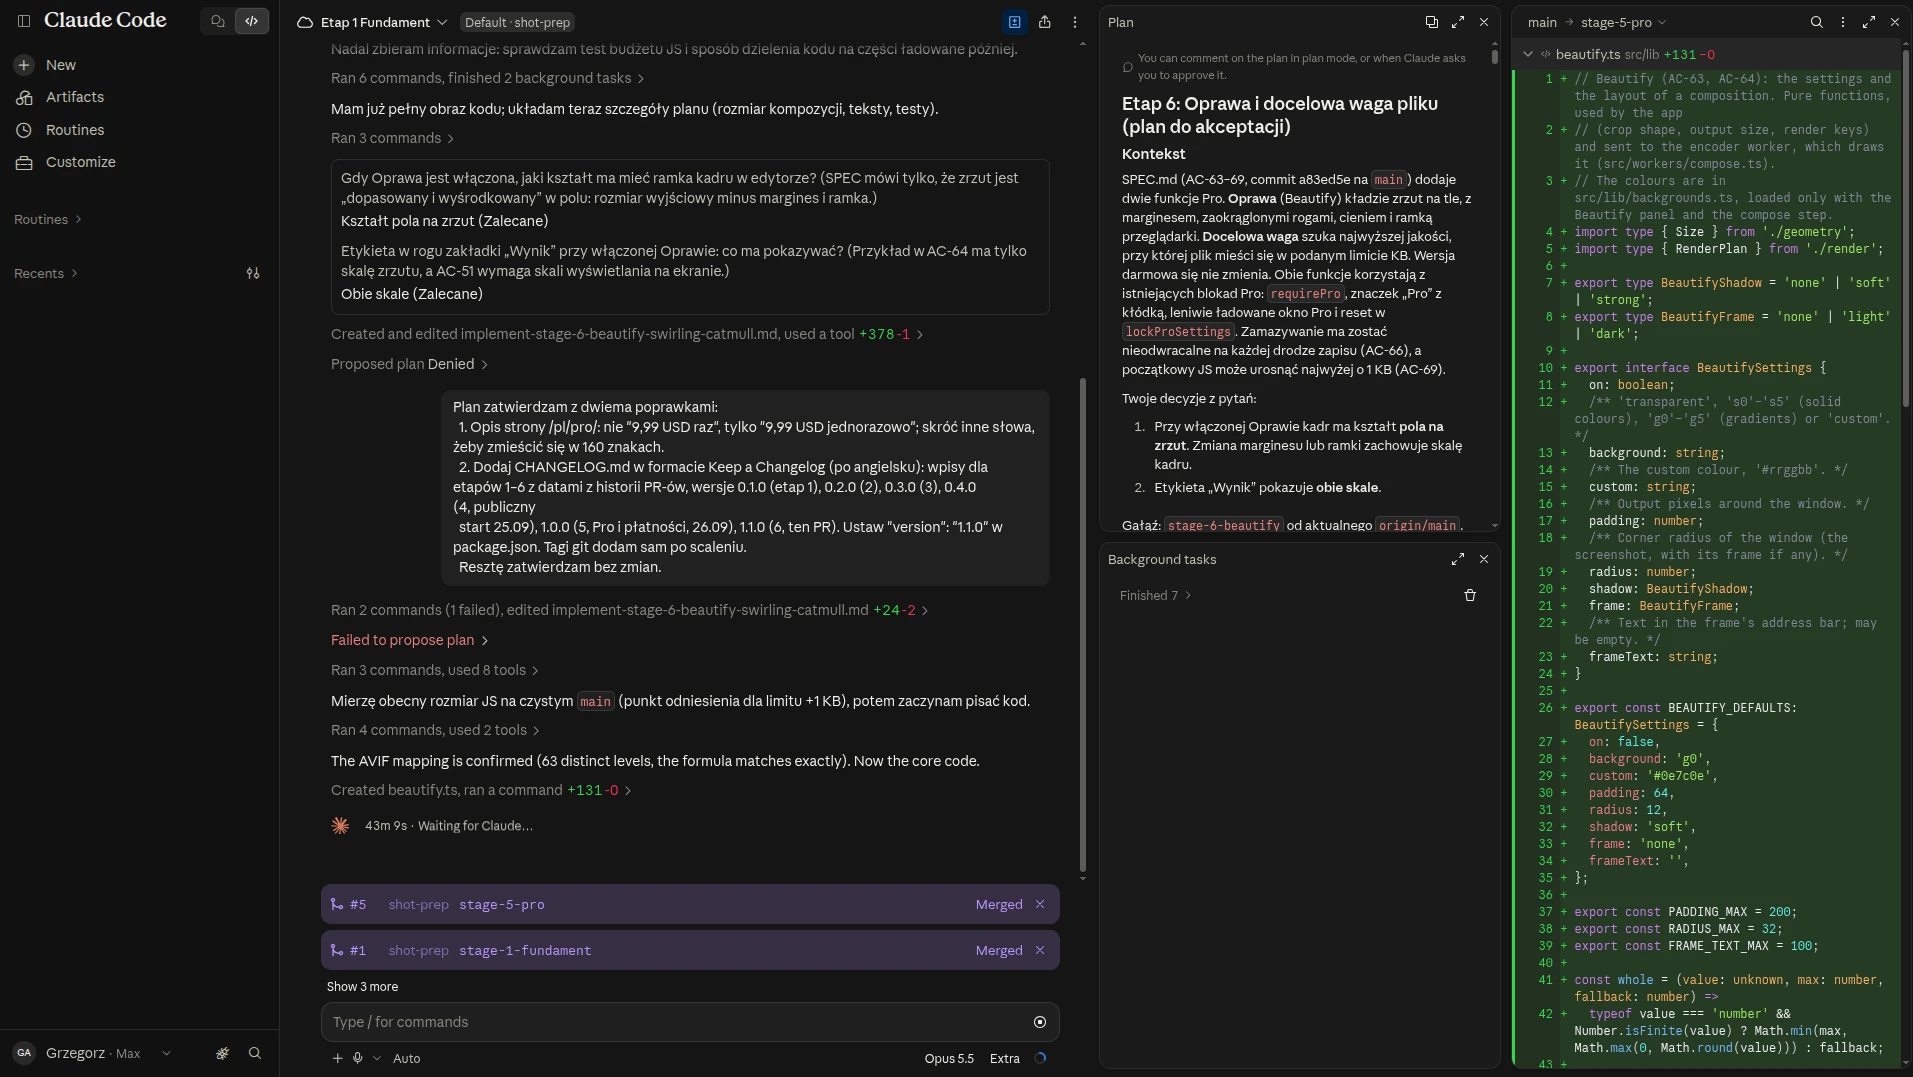
Zasada była jedna: najpierw specyfikacja, potem kod, a każdy etap kończy się tym, że oglądam wynik na podglądzie i mówię tak albo nie. Oś czasu pochodzi z historii repozytorium, a dni są kalendarzowe: model pracował w tle godzinami, a ja zaglądałem między innymi zajęciami, w sumie na 3-4 godziny. Dwa dni to droga do startu, dwa kolejne dołożyły wersję płatną, oprawę zrzutów i poradniki.
- 24.09, 10:31
Specyfikacja przed pierwszą linią kodu
Plik z opisem produktu: co robi, czego nie robi, 51 kryteriów odbioru i podział na pięć etapów. Do tego zasady pracy dla modelu: jeden etap to jedna gałąź i jedna propozycja zmian, każde kryterium ma test z jego numerem w nazwie, a osobny skrypt sprawdza, czy żadnego nie brakuje.
- 24.09, 11:06
Etap 1: szkielet i praca na jednym obrazie
Wklejanie, kadrowanie, format i jakość, zapis w folderze źródłowym, dwie wersje językowe, tryb ciemny, skróty klawiszowe. 19 testów jednostkowych i 68 testów w przeglądarce. Odebrałem po niecałej godzinie.
- 24.09, 11:52
Przegląd wyglądu: „precyzyjne narzędzie”
Pierwsza wersja wyglądała jak każdy interfejs wygenerowany przez AI: pigułki, zaokrąglenia, kolorowe karty. Zapisałem zasady: promienie 2 px na kontrolkach i 0 na panelach, czerwony tylko przy błędzie, żadnych kart z paskiem. Zasady weszły do specyfikacji jako osobne kryterium z testem.
- 24.09, 13:00 do 18:32
Etap 2: kolejka, eksport hurtowy, porównanie
Wiele obrazów naraz, zapis do folderu albo ZIP, wzór nazw plików, własne rozmiary, format AVIF, porównanie przed i po. Po moim przeglądzie dwa dodatkowe kryteria, w tym jeden prawdziwy błąd. Opis niżej.
- 25.09, 14:12 do 19:05
Etap 3: zamazywanie danych
Trzy tryby: czarny prostokąt, pikselizacja i rozmycie. Na każdej ścieżce zapisu oryginalne piksele spod prostokąta nie trafiają do pliku, a do haseł i kluczy zalecany jest czarny prostokąt. W trakcie wyszedł błąd, który po cichu obniżał ochronę. Też niżej.
- 25.09, 23:38
Etap 4: start pod własną domeną
Instalacja jako aplikacja z pracą offline, 18 stron w dwóch językach z opisami zastosowań, katalog narzędzi, analityka bez ciasteczek. Pomiar Lighthouse na produkcji: 98 do 100 punktów w każdej kategorii. Na starcie repozytorium miało 35 commitów, 202 testy i 51 kryteriów odbioru.
- 26.09, 10:34
Dzień trzeci: wersja Pro i płatności
Podział na Free i Pro, blokady w samych akcjach (skrót klawiszowy nie omija zamka), płatność przez Stripe, klucz licencji podpisany kryptograficznie i sprawdzany w przeglądarce, więc Pro działa też offline.
- 26 i 27.09
Etapy 6 i 7: oprawa, docelowa waga, czyste pliki
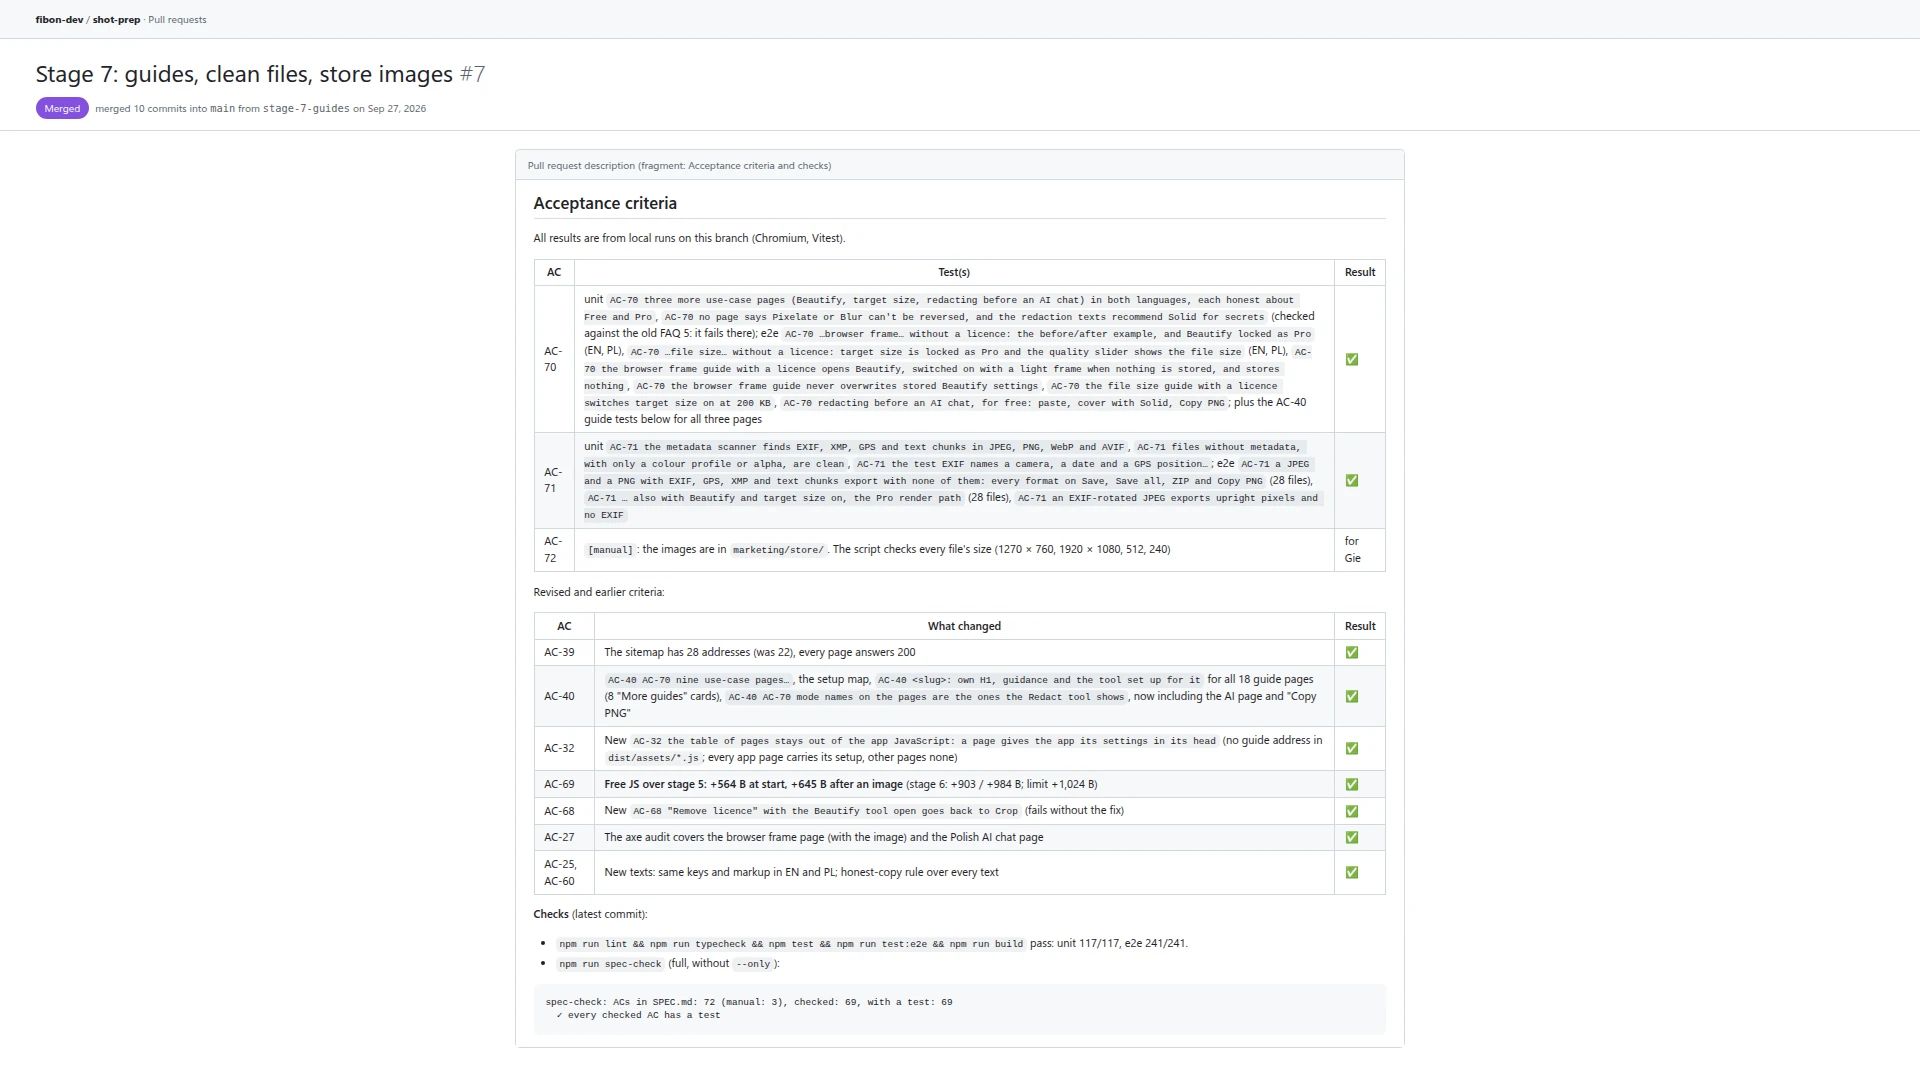
Oprawa zrzutu (tło, ramka przeglądarki, cień) i docelowa waga pliku, obie w Pro. Potem trzy poradniki, testy dowodzące, że zapisane pliki nie niosą położenia ani danych aparatu, i obrazy do katalogów narzędzi. Wersja 1.2.0 z 27 września: 72 kryteria odbioru, 118 testów jednostkowych i 241 w przeglądarce, wszystkie zielone.
Każdy etap kończył się propozycją zmian z tabelą: numer kryterium, nazwa testu, wynik, do tego link do podglądu i lista rzeczy, które mam sprawdzić ręcznie, bo test tego nie umie (okno wyboru folderu, przechwytywanie ekranu, wygląd na telefonie). Czytałem tabelę, klikałem po podglądzie, wracałem z uwagami.
Gdzie decydował człowiek
Model napisał kod, testy i dokumentację decyzji. Ale produkt nie wziął się z modelu. Wziął się z decyzji, które zapadły przed nim i pomiędzy etapami. W pliku z decyzjami dziewiętnaście wpisów ma dopisek „decyzja Gie”. Kilka z nich:
- Czego nie robimy. Żadnego edytora strzałek i tekstu, żadnych kont, żadnej wysyłki na serwer, żadnych instalatorów. To ostatnie ma prostą przyczynę: podpisywanie aplikacji na komputery Apple kosztuje 99 USD rocznie, a niepodpisany plik na Windows straszy użytkownika ostrzeżeniem. Aplikacja w przeglądarce instaluje się bez tego.
- Licencje zależności. Tylko licencje, które pozwalają na użycie komercyjne bez zobowiązań. Dwa wyjątki, oba zapisane z powodem: licencja czcionek i licencja narzędzia do testów dostępności, które nie trafia do produktu.
- Wygląd. Cała zmiana na „precyzyjne narzędzie” po pierwszym podglądzie. Model zrobił to, co robi domyślnie, i to domyślne wyglądało jak wszystko inne.
- Zamazywanie. Domyślny tryb to czarny prostokąt, bo pikselizacja i rozmycie zapraszają do prób odzyskania tekstu. Czarny prostokąt został w wersji darmowej, żeby bezpieczeństwo nigdy nie stało za bramką płatności; pikselizacja i rozmycie są w Pro. Bez suwaka siły rozmycia: słabsze niż minimum robi tekst z powrotem czytelnym, mocniejsze nic nie dodaje. Jeśli ktoś chce miękkie tło pod zrzutem, to jest Oprawa w Pro, funkcja estetyczna, a nie ochrona danych.
Wzorzec jest ten sam, który opisywałem przy generowaniu artykułów: maszyna robi robotę, człowiek decyduje w ustalonych miejscach. Tu tymi miejscami były specyfikacja, odbiór każdego etapu na podglądzie i pytania, które model zadawał, gdy specyfikacja czegoś nie rozstrzygała.
Co się zepsuło
Cztery rzeczy, każda warta opisania, bo każda wyszła na jaw inną drogą.
Zmiana rozmiaru kurczyła kadr. Po etapie 2 zmieniałem na podglądzie rozmiar wyjściowy i patrzyłem, jak ramka kadru robi się coraz mniejsza: 1008 na 567, potem 1008 na 529, potem 940 na 529. Obraz 1920 na 1080 z rozmiarem wyjściowym 1920 na 1080 kończył jako powiększenie o 204 %. Każda zmiana wpasowywała nową proporcję w poprzednią ramkę, więc ramka mogła tylko maleć. Testy tego nie złapały, bo żaden nie zmieniał rozmiaru dwa razy z rzędu. Znalazłem to ręcznie, dostało własne kryterium i test, poprawka weszła przed połączeniem etapu.
Wybór trybu zamazywania po cichu zmieniał poprzedni prostokąt. Na etapie 3 jeden z testów padał w 7 z 11 uruchomień: drugi prostokąt dostawał tryb rozmycia zamiast pikselizacji. Łatwo było uznać to za niestabilny test. Przyczyna siedziała w programie: przyciski trybu zmieniały zaznaczony prostokąt, a świeżo narysowany prostokąt jest zaznaczony. W praktyce: zamazujesz hasło czarnym prostokątem, wybierasz pikselizację do kolejnego fragmentu i hasło po cichu zmienia się w pikselizację. Poprawka rozdzieliła te dwie rzeczy: wybór w panelu dotyczy tylko nowych prostokątów, istniejący zmienia tryb wyłącznie w swoim wierszu na liście. Cały zestaw osiemnastu testów zamazywania przeszedł potem dwadzieścia razy z rzędu, 360 na 360.
Test, który przepuszczał brak ochrony. Sprawdzian, czy zamazanie trafia do pliku, obejmował zapis, zapis hurtowy i ZIP, a kopiowanie do schowka sprawdzał tylko wtedy, gdy formatem wyjściowym był PNG. Przy domyślnym WebP kopiowanie idzie osobną ścieżką, której żaden test nie dotykał. Wersja programu, która na tej ścieżce gubiła zamazania, przechodziła wszystkie dwanaście testów. Wyszło to, gdy osobna sesja kontrolna celowo psuła kod, żeby sprawdzić, czy testy to zauważą. Nie zauważyły, więc doszły trzy nowe.
Dwadzieścia zrzutów 4K, dziewięć wczytanych, reszta „uszkodzona”. Ten błąd siedział od etapu 2 i nie wyszedł w żadnym teście, bo był widoczny tylko na innej maszynie niż kontener, w którym pracował model. Program dekodował każdy obraz w całości tylko po to, żeby poznać jego rozmiar, przy dużej partii przeglądarka odmawiała, a odmowa była raportowana jako uszkodzony plik. Znalazłem to przy niezależnym sprawdzeniu na własnym komputerze. Teraz rozmiar czytany jest z nagłówka pliku, miniatury dekodują się po dwie naraz, a plik, który nie wczyta się za pierwszym razem, dostaje drugą próbę.
Ile to kosztowało
| Pozycja | Ile | Uwaga |
|---|---|---|
| Kredyty na sesje w chmurze | całe 250 USD: 113 po pięciu etapach (26.09 rano), 165 w trakcie etapu 6 (26.09 po południu), reszta na etap 7 i film; końcówkę robiłem już lokalnie | z promocji, więc 0 zł z własnej kieszeni |
| Moja uwaga | 3-4 godziny w sumie | przegląd siedmiu podglądów, dziewiętnaście decyzji, testy na własnym systemie; robione między inną pracą, więc to szacunek, nie pomiar |
| Praca modelu | kilka godzin generowania | sesje w chmurze szły w tle, bez mojej obecności |
| Hosting | 0 zł | strona statyczna, jedyny koszt to transfer |
| Domena | 0 zł | subdomena istniejącej domeny |
Dla skali: licznik jednej z sesji w chmurze pokazał na koniec 266 USD kosztu, liczonego po cenach API, czyli więcej niż cały kredyt. Całą robotę w tej sesji wykonał Opus 5.5.
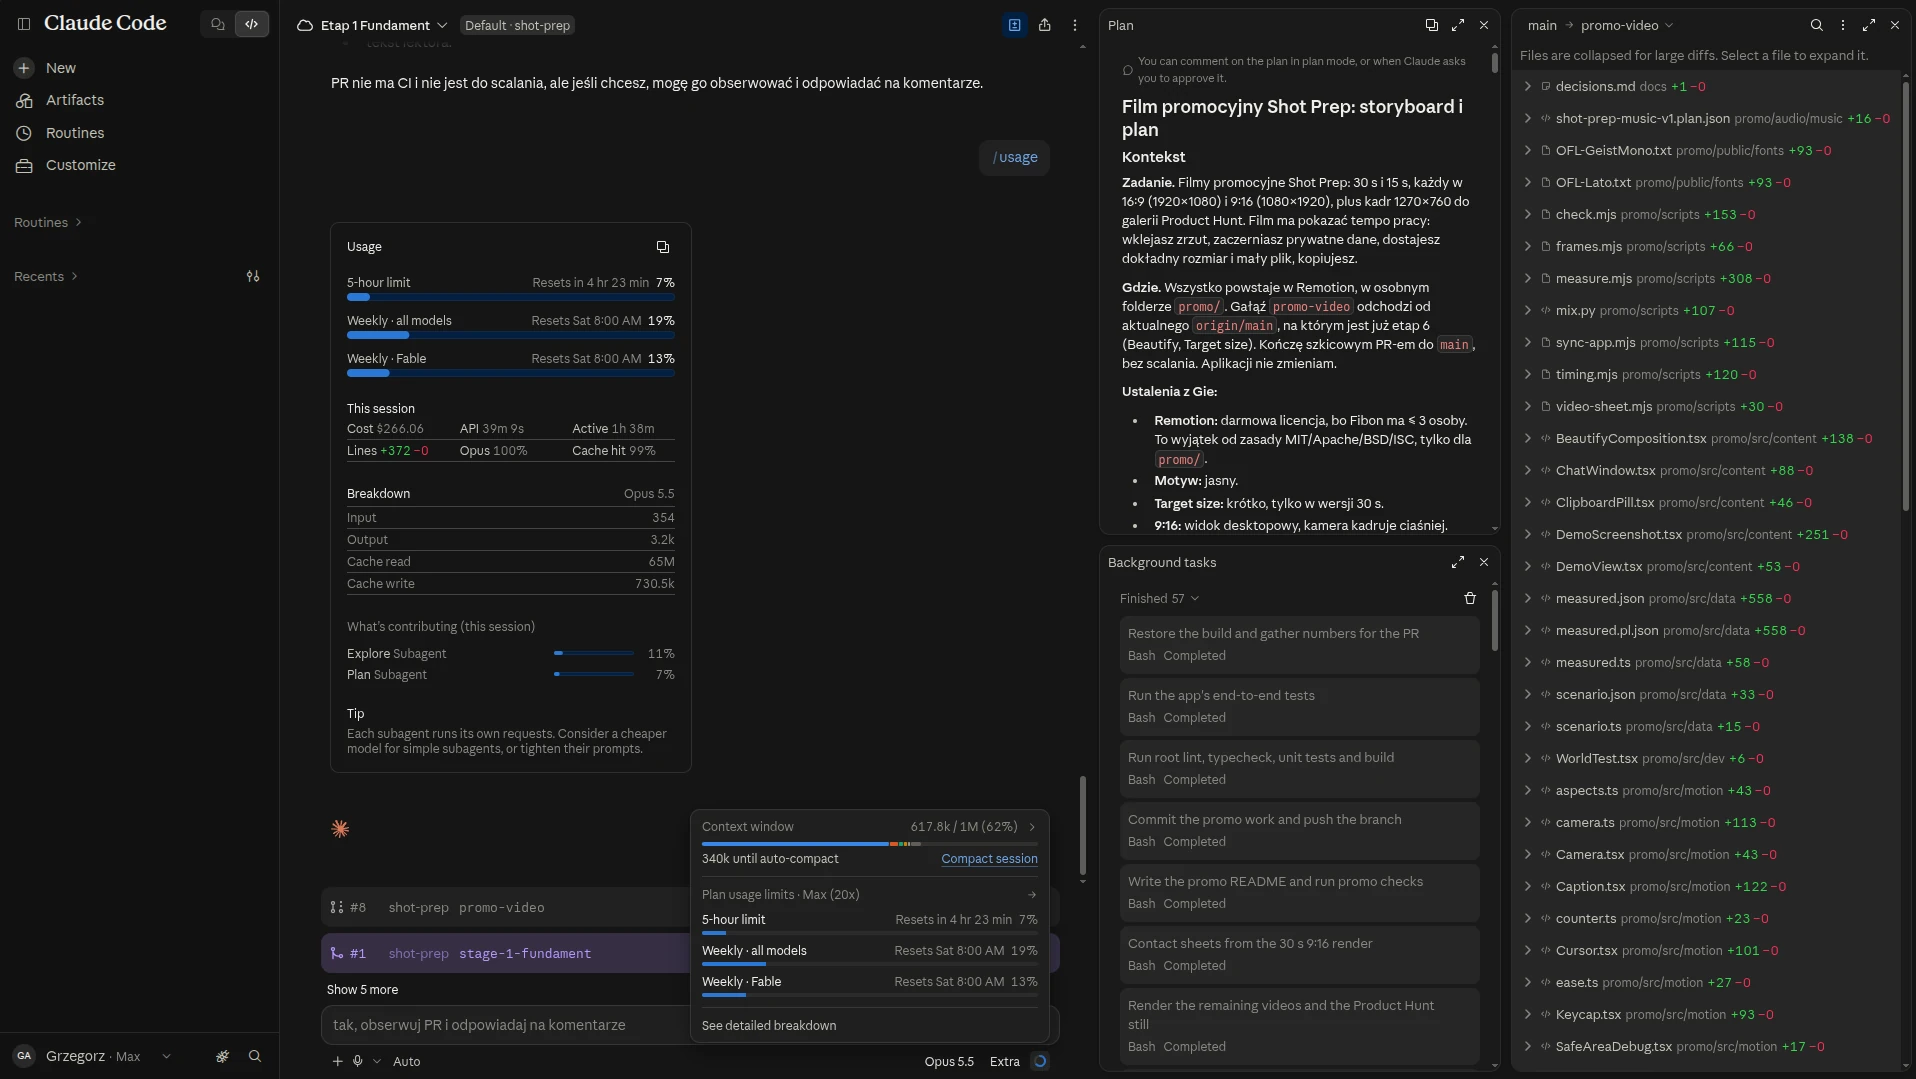
Bez promocji te same sesje zjadałyby limit planu, na którym i tak jestem. Sesja w chmurze nie ma osobnej opłaty za maszynę, więc różnica między „za kredyty” a „bez kredytów” to nie pieniądze, tylko to, ile pracy zmieści się w limicie w danym tygodniu.
Czy Ci się to opłaca
Ten tryb pracy ma sens, gdy spełnisz trzy warunki naraz. Umiesz spisać, co narzędzie ma robić i czego nie ma robić, zanim ktokolwiek zacznie budować. Masz jak sprawdzić wynik: otworzyć, kliknąć, porównać z oczekiwaniem. I akceptujesz, że Twoja praca przesuwa się z budowania na odbiór, bo odbiór nie znika i nie powinien.
Nie ma sensu, gdy liczysz na „jeden prompt i produkt”, gdy nikt po Twojej stronie nie obejrzy wyniku przed użyciem, albo gdy przez narzędzie mają płynąć dane klientów, a Ty nie masz jak przetestować, co się z nimi dzieje. Wtedy szybkość budowy działa przeciwko Tobie.
Dobre pierwsze zadanie na kredyty: mały, wewnętrzny problem, który od dawna rozwiązujesz ręcznie. Skrypt porządkujący eksport z systemu, kalkulator oferty, formularz, który dziś jest arkuszem. Coś, co możesz odebrać w godzinę i czego awaria nikogo nie boli.
Wypróbuj narzędzie z tego artykułu: wklej zrzut ekranu, wybierz rozmiar, zamaż to, co ma zostać w firmie. Bez konta, nic nie wychodzi z przeglądarki. Wersja darmowa wystarcza do pojedynczych zrzutów. Jeśli czegoś brakuje, napisz.
Jeśli zastanawiasz się, co u Ciebie dałoby się zbudować w podobny sposób, opisz problem. Odpowiem, czy to zadanie na dwa dni, dwa tygodnie, czy wcale.
Napisz, co chcesz zbudowaćPod maską
Ta część jest dla ciekawskich. Aplikacja w przeglądarce: Vite, TypeScript i Preact, kadrowanie na Cropper.js, kodowanie obrazów w osobnym wątku przeglądarki, koder AVIF w WebAssembly dogrywany dopiero po wybraniu formatu. Testy w Vitest i Playwright z audytem dostępności axe. Hosting statyczny na Vercelu z nagłówkami bezpieczeństwa plus jedna funkcja serwerowa, która po zakupie w Stripe wydaje podpisany klucz licencji. Skrypt startowy waży 42 KB po kompresji przy budżecie 60 KB ze specyfikacji (pomiar testu po dodaniu wersji Pro). Kod aplikacji to około 11 tys. linii w wersji 1.2.0, testy są osobno.
Czy Claude Opus 5.5 zastępuje Fable 5.1?
Według Anthropic działa na poziomie Fable 5.1 w większości zadań i kosztuje mniej. To nie znaczy, że jest lepszy we wszystkim. Jeśli masz zadanie, na którym Fable daje Ci lepszy wynik, zmierz oba na swoim przykładzie. Dla większości firmowych zastosowań różnica w cenie będzie ważniejsza niż różnica w jakości.
Czy muszę umieć programować, żeby użyć Claude Code w chmurze?
Nie musisz pisać kodu, ale musisz umieć powiedzieć, co ma powstać, i sprawdzić, czy powstało. Bez specyfikacji i bez odbioru dostaniesz coś, co działa w demo i psuje się na Twoich danych. Konto GitHub jest wymagane, bo tam żyje repozytorium.
Czy kredyty dostanie każdy?
Nie. Promocja obejmuje indywidualne plany Pro i Max aktywne 23 września 2026. Odbiór do 7 października, wykorzystanie do 4 listopada, wyłącznie na sesje w chmurze.
Czy Shot Prep wysyła moje zrzuty na jakiś serwer?
Nie. Cała praca na obrazie dzieje się w Twojej przeglądarce, narzędzie nie ma konta. Jedyny kod serwerowy wydaje klucz licencji Pro po zakupie i nie dostaje obrazów. Po pierwszym otwarciu narzędzie działa także bez internetu.
Czy narzędzie jest skończone?
W zakresie, który zaplanowałem, tak. Wersja 1.2.0 z 27 września zamyka siedem etapów: praca na obrazie, eksport hurtowy, zamazywanie, start ze stronami i aplikacją offline, wersja Pro z płatnością, oprawa z docelową wagą pliku oraz poradniki. Co dalej, zależy od tego, czego będą potrzebować użytkownicy, więc jeśli czegoś brakuje, napisz.