22 września Anthropic wypuścił Claude Opus 5.5. Post o premierze był w naszej bazie po minucie, a i tak dowiedziałem się o niej, przewijając X. Dziś pilnuje tego automat, w którym decyzje podejmuje Jev: model AI, który nie pisze ani słowa. Wdrożyłem go 30 września 2026 i mam liczby z własnych danych, a nie z prezentacji producenta.
Z tego artykułu dowiesz się:
- Co to jest Jev i czym różni się od czatu z AI
- Jak pracuje w naszym automacie i które kroki celowo oddałem zwykłemu kodowi
- Jak wypadł na 239 prawdziwych wpisach z września: trafność, czas i koszt
- Czego Jev nie zrobi, na trzech przykładach z naszych danych
- Jak sprawdzić go u siebie na jednej powtarzalnej decyzji
Co to jest Jev
Jev to model AI firmy TypeSafe, pokazany 15 września 2026. Od modeli takich jak Claude czy GPT różni go jedno: nie generuje tekstu. Dostaje porcję danych, na przykład treść posta, i pytania. Oddaje odpowiedzi w jednym z trzech kształtów:
- tak albo nie, jako prawdopodobieństwo od 0 do 1,
- jedna opcja z listy, którą sam układasz,
- pozycja na skali, którą sam definiujesz. Do każdej odpowiedzi dokłada pewność. Nie ma uzasadnienia ani akapitu do przeczytania. Program dostaje wartość i od razu wie, co robić dalej.
Tak Jev przedstawił jego autor, Diogo Almeida:


After co-inventing ChatGPT, I kept asking myself: why have superhuman chat models not led to AGI? I’ve spent the last 2 years in stealth building a new way to train models (RLCD), and a new type of frontier AI model that we are releasing today: Jev • 20-200x faster • 40-400x Show more
Producent deklaruje, że Jev jest 20 do 200 razy szybszy i 40 do 400 razy tańszy od dużych modeli. Tych porównań nie sprawdzałem. Sprawdziłem co innego: u nas odpowiadał w medianie po 0,29 sekundy, a cena Jev w OpenRouterze to 0,042 USD za milion tokenów wejścia, bez opłaty za odpowiedź (stan na 30 września 2026).
Dwie rzeczy warto wiedzieć od razu. Jev nie zastąpi czatu ani modelu, który pisze. A według dokumentacji TypeSafe najlepiej radzi sobie z angielskim, w innych językach trafność jest niższa.
Problem, od którego zaczęliśmy: radar, którego nikt nie czytał
Wcześniej opisałem jeden z naszych przykładów automatyzacji n8n: radar, który zbiera nowości od dostawców. Zbierał bez zarzutu. Post konta Claude o premierze Claude Opus 5.5 z 22 września był w naszej bazie po minucie:


Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family. It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5.
Nikt go tam nie zobaczył. Trzy dni później Notion ogłosił uprawnienia do kolumn, według niego najczęściej zgłaszaną prośbę użytkowników. Post trafił do bazy po 54 minutach i spotkał go ten sam los.
28 września zrobiłem audyt. Wszystkie automaty miały zielone przebiegi. Skutek był taki, że na 452 zebrane newsy do listy pomysłów na treści trafił jeden, a z postów żaden. Ręczny przegląd „trzy razy w tygodniu po 10 minut” istniał od lipca na papierze i nigdy nie ruszył.
Wniosek był niewygodny. Nie brakowało nam AI ani danych. Brakowało kogoś, kto codziennie przesieje kilkanaście wpisów i powie: o tym warto napisać. To jest praca dla modelu, który tylko decyduje.
Jak działa kurator gorących tematów i gdzie pracuje w nim Jev
Kurator to automat w n8n. Co godzinę ocenia nowe wpisy, a raz dziennie wysyła mi na Slacka najwyżej trzy propozycje tematów. Każda propozycja trafia też do bazy pomysłów w Notionie ze statusem „do decyzji”. Przyjmuję ją albo odrzucam ja.
Jev ma w tym automacie jeden krok. Resztę robi kod i jeden model piszący.
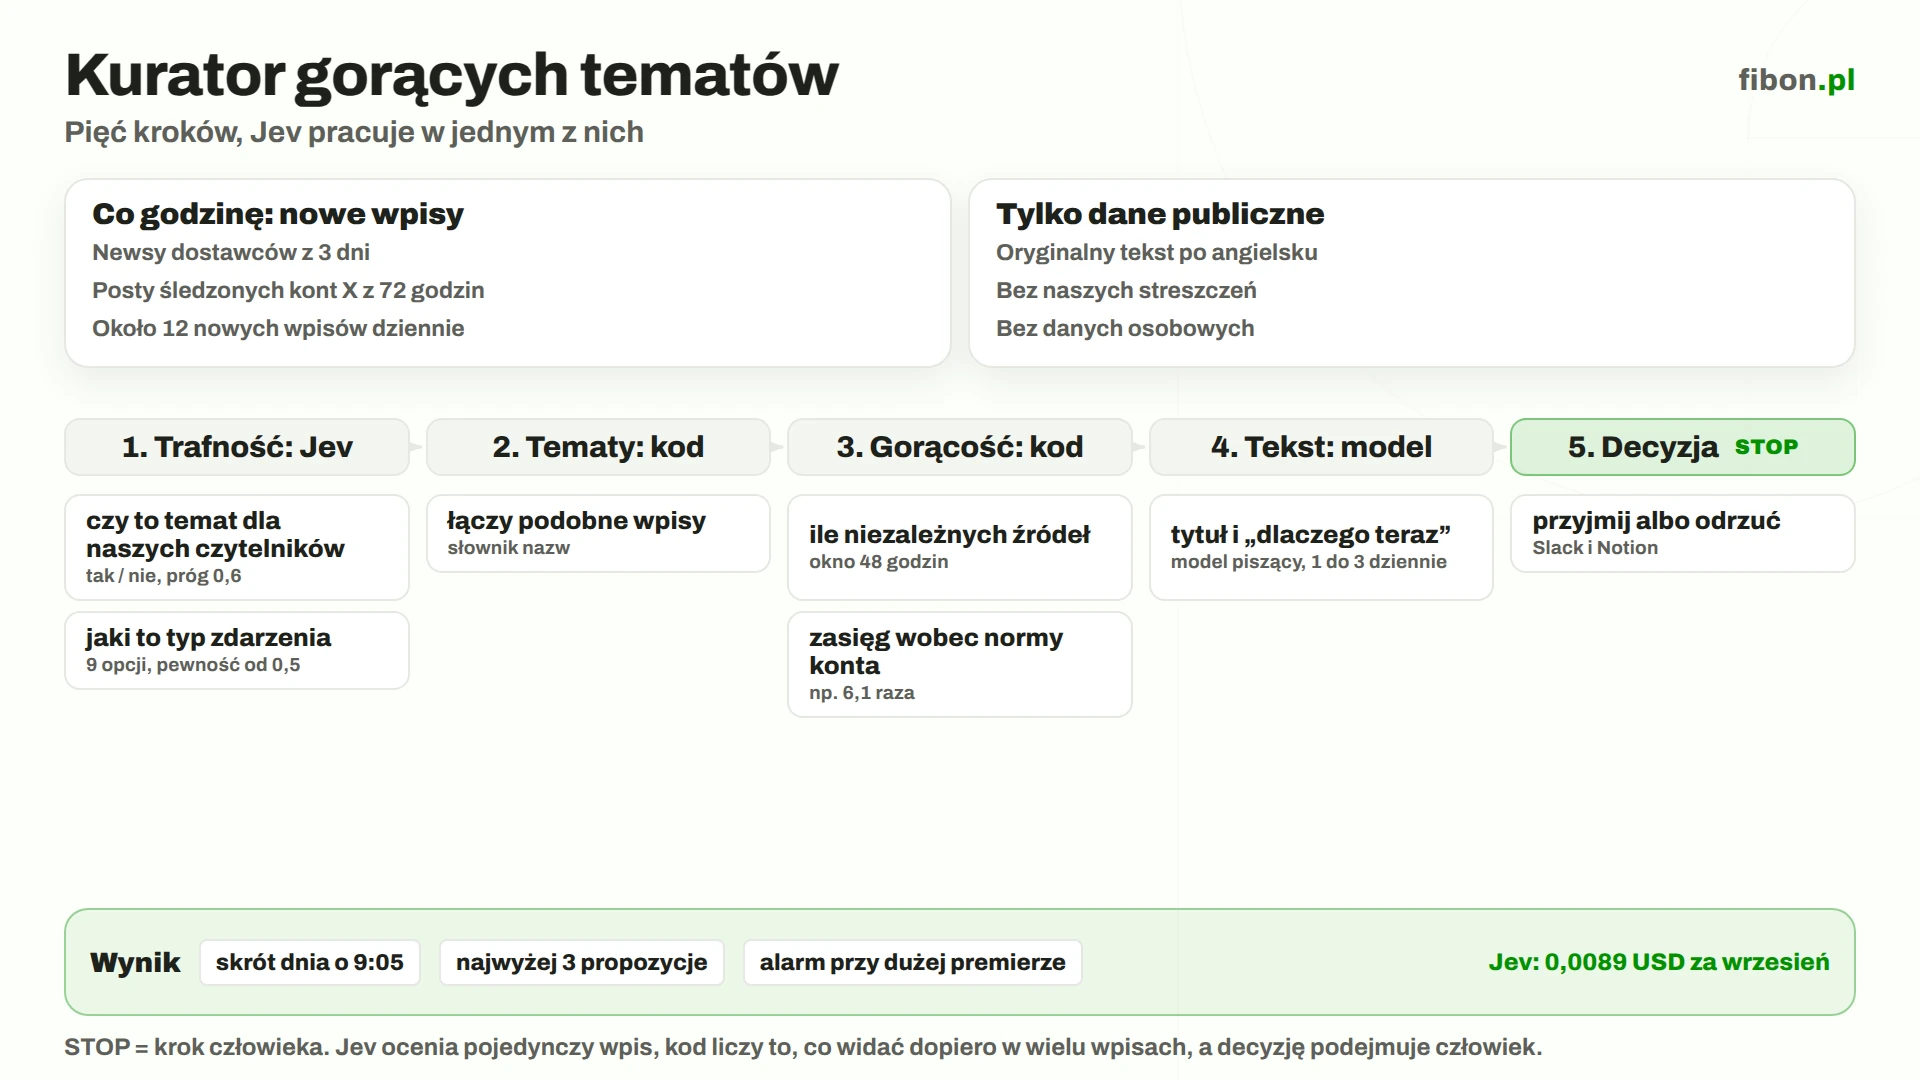
| Krok | Kto go robi | Dlaczego |
|---|---|---|
| Czy wpis jest dla naszych czytelników i jaki to typ zdarzenia | Jev | Zamknięta lista odpowiedzi, dane publiczne, tekst po angielsku, pewność przy każdej odpowiedzi |
| Łączenie wpisów w tematy | kod ze słownikiem nazw | Tematy są otwarte, a Jev wybiera z zamkniętej listy |
| Czy temat jest gorący | kod | To cecha wielu wpisów naraz, w pojedynczym jej nie widać |
| Tytuł propozycji i zdanie „dlaczego teraz” | Claude Sonnet 5.5 | To czyta człowiek, a takich tekstów jest od jednego do trzech dziennie |
| Decyzja | człowiek | Propozycja nie jest jeszcze decyzją |
Każdy wpis to jedno wywołanie z dwoma pytaniami. Pierwsze jest typu tak albo nie: czy ten news albo post jest istotny dla właścicieli firm usługowych, którzy na co dzień używają Claude, n8n albo Notion, na tyle, że warto o nim napisać. Drugie ma listę dziewięciu opcji: jaki to typ zdarzenia (premiera modelu, nowa funkcja, cena albo limity, wycofanie, incydent bezpieczeństwa, poradnik, badania i polityka, wiadomości korporacyjne, szum). Pytania zadaję po angielsku i daję oryginalny tekst wpisu, a nie nasze polskie streszczenie.
Tak wyglądają prawdziwe odpowiedzi z września:
| Wpis | Trafność | Typ zdarzenia (pewność) | Czas |
|---|---|---|---|
| Post Claude: „Introducing Claude Opus 5.5…” | 0,82 | premiera modelu (1,00) | 0,29 s |
| Post Notion: „Column permissions are finally here!…” | 0,84 | nowa funkcja (1,00) | 0,29 s |
| Post Notion: „The backbone of your dock.” | 0,10 | szum (0,98) | 0,27 s |
| News Anthropic: „Anthropic opens Tokyo office” | 0,06 | wiadomości korporacyjne (1,00) | 0,31 s |
Trafność liczy się od 0,6 w górę, a typ zdarzenia przy pewności co najmniej 0,5. Oba progi dobrałem na własnych danych.
Czy Jev się sprawdził: test na 239 wpisach z września
Zanim automat ruszył, puściłem przez Jev cały wrzesień: 239 prawdziwych wpisów, czyli 165 postów śledzonych kont na X i 74 newsy dostawców.
- Jev odpowiedział na 239 z 239 wpisów.
- Mediana czasu odpowiedzi to 0,29 sekundy, a 95% wywołań zmieściło się w 0,40 sekundy.
- Całość kosztowała 0,0089 USD. Żeby ocenić trafność, potrzebny był wzorzec. 73 wpisy dostały etykietę „warto” albo „nie warto”. Etykiety przygotował agent AI, a ja przejrzałem prawie wszystkie i zatwierdziłem je bez zmian. To ważne zastrzeżenie: taki wzorzec służy do dobrania progu, nie jest niezależnym sprawdzianem.
| Próg trafności | Zgodność ze wzorcem | Precyzja | Czułość |
|---|---|---|---|
| 0,5 | 0,89 | 0,85 | 0,91 |
| 0,6 (wdrożony) | 0,90 | 0,88 | 0,91 |
| 0,7 | 0,86 | 0,92 | 0,75 |
Typ zdarzenia zgadzał się ze wzorcem w 65 z 73 wpisów.
Potem odtworzyłem wrzesień godzina po godzinie na kodzie, który dziś pracuje. Kurator złapałby wszystkie sześć premier miesiąca:
| Premiera | Opublikowana | Reakcja kuratora |
|---|---|---|
| Claude Fable 5.1 | 1 września | skrót dnia 2 września o 9:05 |
| Notion 3.7 | 15 września | skrót dnia 17 września o 9:05 |
| Claude Opus 5.5 | 22 września, 18:31 | alarm o 19:05, czyli 34 minuty po poście |
| Notion: uprawnienia do kolumn | 25 września | skrót dnia 26 września o 9:05 |
| n8n Agents | 25 września | skrót dnia 26 września o 9:05 |
| Claude Sonnet 5.5 | 28 września | alarm tego samego dnia o 21:05 |
W całym wrześniu wysłałby 25 propozycji: 17 osobnych i 8 tygodniowych zestawień drobniejszych nowości. Najwyżej trzy dziennie i dwa alarmy. Ani razu nie zapalił się na wpisach, które uznaliśmy za szum: stare newsy, relacje z konferencji, zmiany w zarządach.
Ile to kosztuje: decyzje za grosze, tekst za prawdziwe pieniądze
Liczby z naszych przebiegów:
- ocena 239 wpisów z września: 0,0089 USD,
- jeden przebieg z 33 wpisami: 0,0012 USD,
- jedna propozycja napisana przez Claude Sonnet 5.5: 0,0105 USD. Za cenę jednej napisanej propozycji Jev ocenia ponad 280 wpisów. Stąd układ automatu: tani model przesiewa wszystko, a drogi pisze tylko o tym, co przeszło. Przy naszej skali, około 12 nowych wpisów dziennie, Jev kosztuje nieco ponad cent miesięcznie. To szacunek z pomiaru z 14–29 września, nie rachunek za pełny miesiąc.
I od razu uczciwie: Jev nie jest sposobem na oszczędności. Policzyłem wszystkie miejsca w naszych automatach, w których AI podejmuje decyzję. Przepięcie ich na Jev dałoby około 1,70 zł miesięcznie. Przy kilkudziesięciu decyzjach dziennie rachunek za model i tak jest pomijalny. Wartość leży gdzie indziej: w odpowiedzi, której nie trzeba rozszyfrowywać, i w pewności, na której da się ustawić próg.
Trzy rzeczy, których Jev nie zrobi za Ciebie
Nie odpowie na pytanie o coś, czego nie widać w jednym wpisie
„Czy to gorący temat” brzmi jak pytanie do AI. Nie jest nim. Post o Opus 5.5 i post o uprawnieniach do kolumn wyglądają osobno podobnie, oba dostały trafność powyżej 0,8. Różnica polega na tym, że o premierze Opusa tego samego dnia pisały cztery konta, a o kolumnach jedno. W pojedynczym wpisie tego nie ma. Dlatego gorącość liczy zwykły kod, który zlicza niezależne źródła z 48 godzin.
Nie uratuje reguły opartej na odpowiedzi, którą zaniża
Post Borisa Cherny'ego z zespołu Claude Code o premierze Fable 5.1 dostał trafność 0,31. Był pisany osobistym tonem, więc Jev uznał, że to nie temat dla czytelników. Typ zdarzenia rozpoznał za to poprawnie: premiera modelu, pewność 0,91. Reguła „premiera u ważnego dla nas dostawcy zawsze daje propozycję” opiera się więc na typie zdarzenia i słowniku nazw modeli, a nie na trafności.
Nie zastąpi myślenia o regułach
Pierwsza wersja reguł dała 58 propozycji w miesiącu zamiast 17. Jev się nie mylił. Poprawnie rozpoznawał na przykład „GPT-6 Astra is now available in Notion” jako nowość. Tyle że to nie jest premiera u dostawcy, o którym piszemy, a każda drobna funkcja z jednego posta stawała się osobnym pomysłem. Poprawiłem reguły: doszedł słownik modeli i zbiorcza propozycja raz w tygodniu. Pytań do Jev nie zmieniłem.
Powtarzalność i awarie: czego się spodziewać po Jev
Przy wdrożeniu wyszedł mały test powtarzalności. Te same 33 wpisy Jev ocenił trzy razy w ciągu 33 minut.
- W każdym przebiegu wskazał ten sam zbiór 17 trafnych wpisów.
- Prawdopodobieństwo dla jednego wpisu różniło się najwyżej o 0,04, a mediana różnicy to 0,01.
- Typ zdarzenia był zgodny w 32 z 33 wpisów. Jedyna zmiana dotyczyła wpisu z pewnością 0,45–0,50, czyli na progu, poniżej którego typu w ogóle nie bierzemy pod uwagę.
- Koszt każdego przebiegu był identyczny: 0,001202 USD. To próba 33 wpisów z jednego dnia, nie badanie. Pokazuje jednak, czego się spodziewać. Odpowiedzi są stabilne, ale wpis z wynikiem tuż przy progu, na przykład 0,58–0,62, może raz przejść, a raz nie. Osiem z 33 wpisów leżało w pobliżu progu.
Druga sprawa to awarie. Jev działa u jednego dostawcy, a adres, pod którym go wołamy, ma w nazwie „alpha”. U nas błąd Jev zatrzymuje przebieg i wywołuje alarm. Automat nie udaje, że nic nie znalazł. Drugi bezpiecznik: 96 godzin bez żadnego nowego wpisu też jest błędem.
Wiem, po co to jest. Badając Jev, odkryłem przy okazji, że dwa nasze starsze klasyfikatory od sześciu tygodni nie działały, bo dostawca wyłączył model, na którym stały. Automaty przez cały ten czas meldowały sukces.
Jak używają Jev inni
Własne liczby mam z jednego wdrożenia. Dla porównania kilka cudzych, z zastrzeżeniem, że to deklaracje autorów, których nie sprawdzałem.
Guillermo Rauch, szef Vercela, o kontroli bezpieczeństwa poleceń w ich narzędziu:

We're seeing extraordinary results from @typesafeai. Default mode in 𝚏𝚡 is auto, with a safety reviewer analyzing every command. That reviewer runs on GPT Luna today. Jev is up to 18x faster (p95) *and* more accurate. It's coming to @vercel AI Gateway and likely new default.


We benchmarked fx auto mode (safety) classifier with @typesafeai's Jev. tl;dr: ~5-18x faster and more accurate than 𝚐𝚙𝚝-𝟻.𝟼-𝚕𝚞𝚗𝚊, our current top choice

Shahriar Tajbakhsh z Metaview, platformy do rekrutacji:

at @MetaviewAI, over the weekend we shipped @typesafeai's jev into every agent on metaview. candidate searches in our sourcing product that took minutes now take seconds. same accuracy, ~10x faster, meaningfully cheaper per search. but the speedup isn't the interesting part. Show more
Zespół Langfuse użył Jev jako sędziego, który ocenia odpowiedzi innych modeli, i opisał wynik na swoim blogu: zgodność z werdyktem dużego modelu w 91,5% przypadków przy koszcie 160 USD za milion ocen zamiast 33 000 USD. Wymienił też trzy ograniczenia, które pokrywają się z naszymi. Jev nie ma opcji „nie wiem”, nie podaje uzasadnienia i traci trafność, gdy dostanie za dużo zbędnego kontekstu.
Reona Shimada z Classmethod podmienił na Jev klasyfikator kierujący zapytania do modeli. Mediana czasu decyzji spadła z 1,55 sekundy do 0,27–0,42 sekundy, a wszystkie 39 prób trafiło tam, gdzie powinny.
Wzór się powtarza: Jev wchodzi w miejsce jednego, wąskiego kroku decyzyjnego, a nie całego systemu.
Kiedy Jev nie pasuje
- Gdy człowiek musi wiedzieć dlaczego. W naszym automacie przyjmującym maile model pisze zdanie uzasadnienia, które czytam przy akceptacji. Jev go nie napisze.
- Gdy pytanie dotyczy wielu rzeczy naraz. Trend, gorącość albo „czy to się powtarza” policzy kod.
- Gdy treść jest po polsku. Producent sam zastrzega niższą trafność poza angielskim, więc trzeba to najpierw sprawdzić na własnych przykładach.
- Gdy w danych są dane osobowe, na przykład maile klientów. To nie zakaz, tylko formalności. Łączymy się z Jev przez OpenRouter, którego regulamin od 31 sierpnia 2026 zawiera umowę powierzenia danych. Przed pierwszym takim użyciem trzeba jednak sprawdzić listę podwykonawców i dopisać usługę do własnej dokumentacji RODO. O ustawieniach prywatności pisałem przy okazji OpenRouter w n8n.
Po tygodniu działania
Na dziś mam pierwszy dzień. Były trzy przebiegi i w każdym Jev odpowiedział na 33 z 33 wpisów. Powstała jedna propozycja: post Notion o AI pracującym w Notionie, z zasięgiem 6,1 raza większym niż zwykle na tym koncie. Jej napisanie kosztowało 0,0105 USD. Rekord w bazie pomysłów i wiadomość na Slacku sprawdziłem u celu, a nie tylko w zielonym przebiegu automatu.
Jak sprawdzić Jev u siebie
Wybierz jedną powtarzalną decyzję
Taką, którą ktoś podejmuje wiele razy dziennie, patrząc na jedną rzecz naraz: zgłoszenie, opinię, wpis, pozycję na liście.
Zbierz kilkadziesiąt prawdziwych przykładów i oznacz je sam
Nam do dobrania progu wystarczyły 73. Bez własnych przykładów nie dowiesz się, czy model rozumie Twoje kryteria.
Ułóż pytanie z zamkniętą listą odpowiedzi
Każda opcja dostaje jednozdaniowe kryterium. Pytaj tylko o to, co widać w jednym elemencie.
Dobierz próg na swoich przykładach
Nie zakładaj z góry 0,5. U nas najlepiej wypadło 0,6, a przy 0,7 gubiła się co czwarta trafna pozycja.
Zrób głośny alarm i zostaw decyzję człowiekowi
Błąd modelu ma zatrzymać automat, a nie zamienić się w „nic nie znaleziono”. Wynik traktuj jak propozycję.
Podsumowanie: klocek, nie bohater
Jev jest tani, szybki i powtarzalny. Działa, gdy pytasz o to, co widać w jednym wpisie, i gdy odpowiedź mieści się na liście. Resztę w naszym kuratorze robi kod, droższy model i człowiek. To mały, dobrze dopasowany klocek. Prawdziwa zmiana jest gdzie indziej: po trzech miesiącach ktoś wreszcie czyta to, co zbieraliśmy.
Masz decyzję, którą ktoś podejmuje kilkadziesiąt razy dziennie? Sprawdzimy, czy da się ją oddać automatowiCo to jest Jev?
Jev to model AI firmy TypeSafe, który nie generuje tekstu. Odpowiada na pytania w trzech kształtach: tak albo nie, jedna opcja z listy albo pozycja na skali, zawsze z podaną pewnością. Nadaje się do sortowania, oceniania i kierowania spraw w programach i automatach.
Ile kosztuje Jev?
W OpenRouterze 0,042 USD za milion tokenów wejścia, bez opłaty za odpowiedź (stan na 30 września 2026). U nas ocena 239 wpisów kosztowała 0,0089 USD.
Czy Jev działa po polsku?
Działa, ale producent zastrzega, że najlepiej radzi sobie z angielskim, a w innych językach trafność jest niższa. Dlatego w naszym automacie dostaje oryginalny angielski tekst wpisu. Polskie treści warto najpierw sprawdzić na własnych przykładach.
Czy Jev zastąpi ChatGPT albo Claude?
Nie. Jev nie pisze, nie streszcza i nie prowadzi rozmowy. Zastępuje duży model tylko w jednym rodzaju pracy: w podejmowaniu prostych, powtarzalnych decyzji.
Czy mogę użyć Jev w n8n?
Tak, przez węzeł HTTP Request i klucz OpenRouter. Jev ma osobny adres do decyzji i nie działa przez zwykły węzeł modelu czatowego.
Czy mogę wysyłać do Jev dane klientów?
To kwestia formalności, a nie zakazu. Regulamin OpenRoutera od 31 sierpnia 2026 zawiera umowę powierzenia danych, ale przed pierwszym użyciem sprawdź listę podwykonawców i własną dokumentację RODO. To nie jest porada prawna.