 Grzegorz Adamczyk
We wrześniu napisałem, że Jev, model w naszym kuratorze gorących tematów, zgadza się z moją oceną w 90% przypadków. 3 października oceniłem na ślepo 41 nowych wpisów i wyszło 48%. Tego samego dnia okazało się, że drugi nasz automat z AI od sześciu tygodni nie oceniał niczego, a codziennie meldował sukces. Oba problemy wyłapały evale, czyli egzaminy dla AI z kluczem odpowiedzi. Pokazuję, jak je zbudowaliśmy w n8n zwykłymi węzłami, ile kosztowały i co dała poprawka.
Z tego artykułu dowiesz się:
- Czym są evale w AI i dlaczego najtrudniejszą częścią nie jest kod
- Co pokazał Anthropic 28 września i co z tego przyda się firmie bez działu ML
- Jak zrobić eval w n8n, gdy darmowa wersja liczy wyniki tylko w jednym workflow
- Dwa nasze evale z liczbami: 90% → 48% → 84% w kuratorze i +21 punktów w filtrze zleceń
- Od czego zacząć u siebie, krok po kroku
Czym są evale w AI
Eval to egzamin próbny dla AI z kluczem odpowiedzi. Bierzesz kilkadziesiąt prawdziwych przypadków, na przykład maile, oferty albo wpisy. Przy każdym zapisujesz, jaka odpowiedź jest dobra. Puszczasz je przez automat i liczysz, ile razy trafił. Zmieniasz prompt albo model i puszczasz ten sam egzamin jeszcze raz.
Przykład z automatu, który rozdziela pocztę na etykiety:
| Twoja odpowiedź | Odpowiedź automatu | |
|---|---|---|
| „Szukamy kogoś do wdrożenia Notion w biurze” | lead | lead ✅ |
| „Zwiększymy Twój ruch o 300%, umówmy się na call” | oferta sprzedażowa | lead ❌ |
| „Przypomnienie o jutrzejszym webinarze” | inne | inne ✅ |
Zwykły test w programowaniu mówi „działa” albo „nie działa”. Model językowy odpowiada za każdym razem trochę inaczej, więc tu wynikiem jest procent trafień.
Czy to tylko dla programistów? Nie. Porównanie dwóch kolumn to kilka linijek kodu, które dziś napisze Ci Claude. Najtrudniejsza część to klucz odpowiedzi: ktoś musi wiedzieć, czy dany mail to lead, a czy dana oferta jest warta uwagi. To wiedza o Twojej firmie, nie o programowaniu.
Co pokazał Anthropic 28 września
28 września Anthropic opublikował na nowym blogu dla deweloperów wpis Lance'a Martina „Automating eval design and hillclimbing with Claude”. Do Claude Code doszły dwie komendy: /claude-api build-eval buduje zestaw testów do Twojej aplikacji, a /claude-api hillclimb poprawia ją krok po kroku i każdą zmianę sprawdza na tym zestawie.


Claude can now help you build evaluations and hillclimb on them. In this article, we share guidance on eval design & skills that Claude Code can use to improve your applications. claude.dev/blog/automatin…
Post miał 3 października 2 061 691 wyświetleń i 17 564 zapisania, prawie dwa razy więcej niż polubień. Ludzie zapisywali go na później, czyli temat jest ważny, ale nie od razu jasny.
Z wpisu najbardziej przydały nam się dwie zasady:
- Przypadek jest dobry, gdy dwóch znawców oceniłoby go tak samo. Jeśli Ty i Twój pracownik oceniacie coś inaczej, to nie jest dobry przypadek do testu.
- Zbiór, na którym poprawiasz, musi być inny niż zbiór, na którym mierzysz. Inaczej poprawiasz automat pod konkretne przykłady, a nie pod prawdziwą pracę. Wpis ma też przykład z pieniędzmi: asystent obsługi zgłoszeń na 14 odłożonych zgłoszeniach podniósł trafność z 78,6% do 90,5% przy mniej więcej jednej piątej kosztu. To dobry wynik, ale na 14 przypadkach. Przewodnik Anthropic sam podaje, że przy 25 przypadkach i dwóch powtórzeniach margines wynosi około 14 punktów, więc takie liczby czyta się z rezerwą.
Głos krytyczny też jest. Hamel Husain, który uczy budowania evali, przetestował narzędzie i napisał, że „pushes you to create an eval before looking at data”, czyli każe budować test, zanim obejrzysz dane. Jego rada: na razie wstrzymać się z tym narzędziem. Nasze doświadczenie z 3 października mówi to samo innymi słowami, o czym niżej.
Evale w n8n: węzeł Evaluation i jego limit
Nasze automaty z AI działają w n8n, więc pierwsze pytanie brzmiało: czy n8n umie to samo. Umie. Ma węzeł Evaluation i zakładkę Evaluations: przypadki trzymasz w tabeli (Data Table albo arkusz Google), n8n puszcza przez workflow każdy wiersz i zapisuje odpowiedź obok Twojej.
Jest jednak limit, który łatwo przeoczyć. Na wersji n8n na własnym serwerze, darmowej i zarejestrowanej, eval z metrykami (węzeł Set Metrics, wykres w zakładce Evaluations) działa tylko w jednym workflow. Lżejsza wersja, w której oglądasz wyniki w tabeli, działa wszędzie. Przy dziesięciu automatach z AI jeden slot nie wystarcza.
Dlatego zrobiliśmy inaczej i nie omijamy przy tym licencji, tylko nie używamy płatnego panelu:
- Krok AI każdego automatu wydzielamy do osobnego małego workflow. Dostaje tekst, oddaje odpowiedź i niczego nie zapisuje. Produkcja woła go tak samo jak przedtem.
- Jeden wspólny egzaminator bierze przypadki z tabeli, woła ten sam krok AI, którego używa produkcja, i porównuje odpowiedzi z kluczem. Wynik liczy zwykły węzeł Code.
- Cztery tabele w n8n: spis automatów, przypadki z kluczem, każda odpowiedź modelu i wyniki przebiegów.
- Alarm na Slacku, gdy model zwraca błędy, gdy nic nie sprawdzono albo gdy trafność spadła o więcej niż 15 punktów. Egzaminator chodzi co poniedziałek rano.
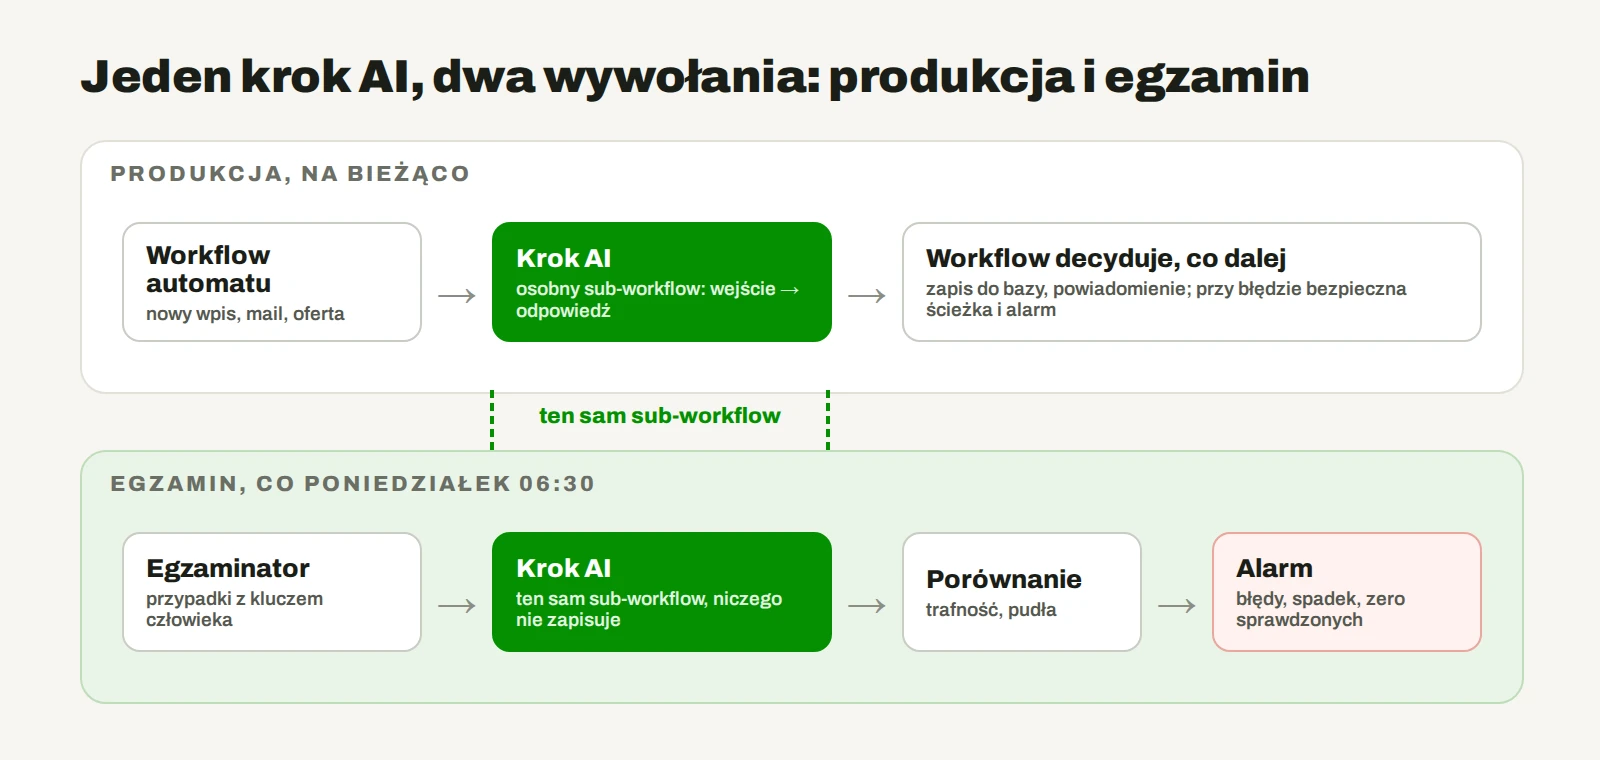
Nowy automat to dziś nowe wiersze w tabeli i jeden wydzielony krok, a nie budowa evala od zera.
Trzy pułapki, które warto znać, jeśli wolisz wbudowany węzeł:
- Metryki zapisują się dopiero po kliknięciu „Run Test” w zakładce Evaluations. Zwykłe uruchomienie workflow ich nie zapisuje.
- W workflow z dwoma triggerami edytor potrafi wybrać trigger evala i jednym kliknięciem puścić cały zestaw przez płatne API (zgłoszenie #38882, otwarte w dniu pisania).
- Bez operacji „Check If Evaluating” egzamin robi to samo co produkcja: zapisuje do bazy i wysyła powiadomienia za każdy przypadek.
Eval 1: kurator tematów, 90% → 48%
Kurator gorących tematów to automat, który co godzinę czyta wpisy z X i newsy dostawców, a model Jev decyduje, czy wpis jest wart naszej uwagi. We wrześniu dobrałem próg na 73 wpisach i wyszła zgodność 0,90. W tamtym artykule zaznaczyłem, że to nie jest niezależny sprawdzian. 3 października go zrobiłem.
Wziąłem wszystkie 41 wpisów, które kurator ocenił w produkcji od 30 września do 2 października, i oceniłem je sam, na ślepo: bez odpowiedzi Jev, w losowej kolejności, z tłumaczeniem pod oryginałem. Zajęło to 24 minuty. Osiem wpisów oznaczyłem „nie wiem” i wypadły z pomiaru. Z pozostałych 33 losowo odłożyłem 21 do sprawdzianu, którego nie wolno było używać przy poprawkach.
| Zbiór | Sprawdzone | Zgodność | Precyzja | Czułość |
|---|---|---|---|---|
| Wrzesień, zbiór do dobrania progu | 73 | 0,90 | 0,88 | 0,91 |
| Nowe wpisy, ocena na ślepo | 21 | 0,48 | 0,57 | 0,33 |
Precyzja mówi, ile z tego, co Jev puścił, było naprawdę dobre. Czułość mówi, ile dobrych wpisów w ogóle zauważył. Czułość 0,33 znaczy, że dwa z trzech dobrych tematów przeszły obok nas. Z dziesięciu wpisów, które uznałem za materiał na cały artykuł z pochodnymi, Jev puścił trzy.
Przegapione były na przykład:
- „You can now mod Claude Code: change how it behaves, customize the UI, swap in your own features” od @ClaudeDevs, pewność Jev 0,42;
- „Barclays scales Claude to upgrade operations and improve client experience” od Anthropic, pewność 0,12;
- badanie Anthropic „Can we predict the jobs robots will do?”, pewność 0,16. Dlaczego? Zmiana progu nic nie dawała: od 0,2 do 0,6 trafnych było 17–19 na 33. Winne było pytanie. 9 z 11 przegapionych wpisów należało do kategorii, które nasze pytanie do modelu wprost wymieniało jako „nie”: sprawy firmowe, badania, szczegóły dla programistów. Jev robił dokładnie to, o co go poprosiliśmy. Tylko prośba nie zgadzała się z tym, czego dziś szukamy.
A skąd wrześniowe 0,90? Moja hipoteza, której nie zmierzyłem: we wrześniu etykiety proponował agent AI, a ja je przeglądałem i zatwierdzałem. Mierzyliśmy więc zgodność z kluczem, który powstał pod wpływem tych samych założeń co pytanie do modelu. Ślepa ocena na nowych wpisach wyłapała to w 24 minuty.
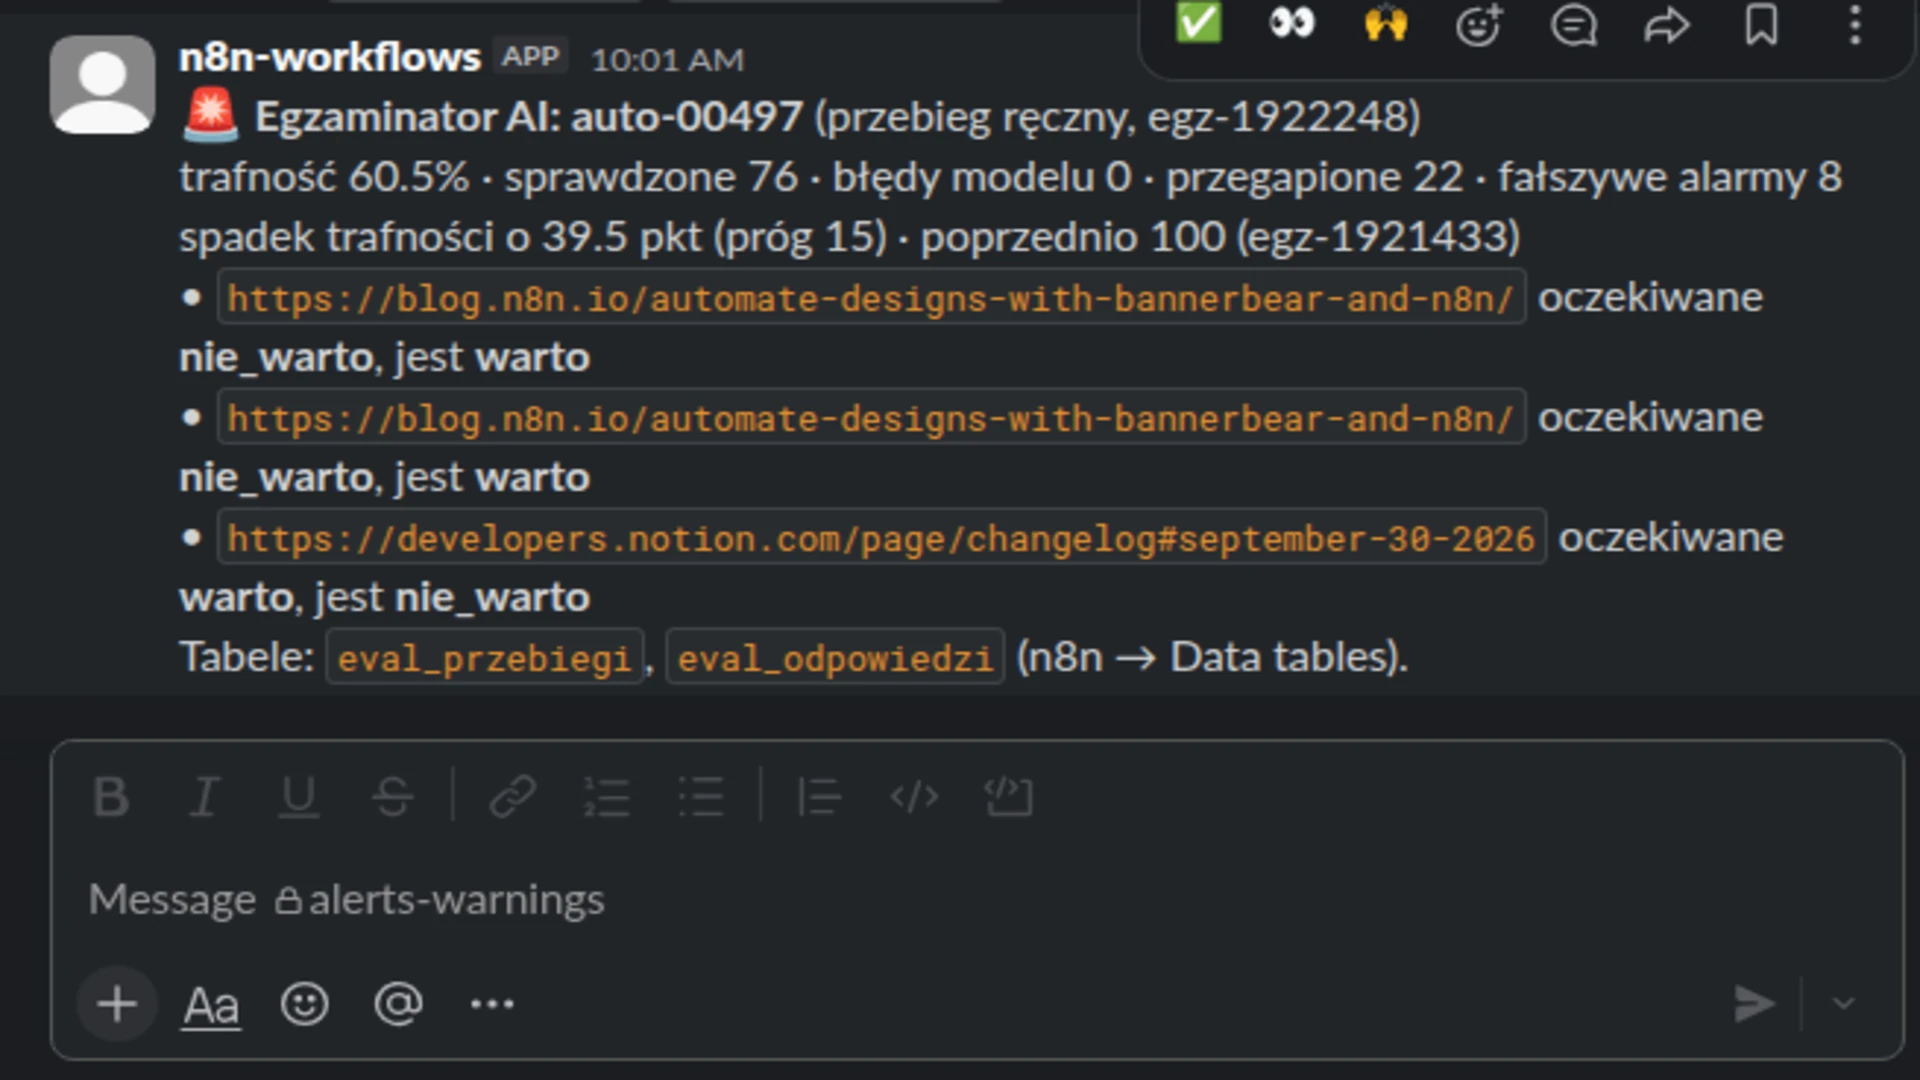
Alarm przyszedł sam. Egzaminator wysłał na Slacka: „trafność 60.5%, spadek o 39.5 pkt (próg 15)”. Cały przebieg, 76 wywołań modelu, kosztował około 0,003 USD.
Poprawka i drugi pomiar
Zmieniliśmy tylko kryteria w pytaniu do Jev, próg został ten sam. Pudła z porannego sprawdzianu już przeczytaliśmy, więc nie nadawał się do uczciwego pomiaru nowej wersji. Potrzebny był świeży zbiór. Znalazł się we wrześniu: z 239 wpisów etykietę dostały tylko 73, więc pozostałych nikt jeszcze nie oceniał. Wylosowałem 40, oceniłem je na ślepo w 7 minut i 32 zostały w pomiarze.
| Na tych samych 32 wpisach | Zgodność | Precyzja | Czułość |
|---|---|---|---|
| Stare kryteria | 0,75 | 1,00 | 0,47 |
| Nowe kryteria | 0,84 | 1,00 | 0,67 |
Wpisy, które według mnie wystarczą na post: stara wersja puściła 1 z 7, nowa 5 z 7. Fałszywych alarmów nie było w żadnej wersji. Naprawione zostały między innymi wpisy z changelogu API Notion i „We've just added local support to Projects in Claude Code”. Jedno nowe pudło: krótki post @NotionHQ „Create calendar events in natural language!” nowa wersja wzięła za ogólnik.
Nową wersję wdrożyliśmy bez ryzyka. Weszła do workflow jako wariant do porównania, a produkcja dostawała starą, dopóki pomiar nie wyszedł. Trzy przebiegi kosztowały razem około 0,013 USD.
Jedna rzecz z tego pomiaru, którą warto zapamiętać: ta sama stara wersja ma 0,75 na wpisach z września i 0,48 na wpisach z października. Liczba z evalu zależy od zbioru. Wersje porównuje się zawsze na tym samym zbiorze, a nie z liczbą sprzed miesiąca.
Eval 2: filtr zleceń, winny był prompt, nie model
Drugi automat przegląda oferty zleceń z serwisu dla freelancerów i decyduje, które pokazać, a które pominąć. 16 sierpnia dostawca wyłączył model, z którego korzystał. Od tego dnia każde wywołanie kończyło się błędem, automat wybierał bezpieczną ścieżkę „pokaż wszystko” i meldował sukces. We wrześniu 990 z 990 ofert dostało dopisek „AI niedostępne”. Nikt nie dostał alarmu przez sześć tygodni.
Naturalny odruch to wymienić model. Zanim to zrobiliśmy, oceniłem 40 ofert i puściliśmy je przez cztery modele. Na 19 ofertach odłożonych do sprawdzianu najlepszy wynik ze starym promptem wynosił 68,4%, a każdy model przegapiał od 10 do 14 z 24 dobrych odpowiedzi. Wszystkie myliły się w tę samą stronę: odrzucały zlecenia na wideo. Powód siedział w prompcie z czerwca, który mówił, że wideo nie pasuje. Od tamtej pory zaczęliśmy robić filmy.
| Model | Stary prompt | Nowy prompt |
|---|---|---|
| Jev (próg 0,5) | 68,4% | 89,5%, 0 z 24 dobrych przegapionych |
| Gemini 3.5 Flash Lite | 68,4% | 84,2% |
| gpt-oss-120b | 63,2% | 71,1% |
Po dopisaniu do opisu zadania, czym się naprawdę zajmujemy, trafność wzrosła o 21 punktów. Ciekawostka: najlepiej wypadł Jev, choć jego producent pisze, że najlepiej radzi sobie po angielsku, a oferty są po polsku. Bez evalu wybralibyśmy model po opisie z dokumentacji.
Czego się nauczyliśmy
- Klucz odpowiedzi daje człowiek, na ślepo. Etykiety zaproponowane przez AI i tylko przejrzane przez człowieka dały nam 0,90, które okazało się 0,48.
- Najpierw opis zadania, potem model. W obu automatach winny był prompt. Porównywanie modeli na złym prompcie mierzy, który model najlepiej wykonuje złe polecenie.
- Błąd modelu ma wychodzić jako błąd. Krok AI, który przy błędzie oddaje „bezpieczną” odpowiedź, ukrywa awarię. Bezpieczną ścieżkę wybiera workflow wyżej, a egzaminator widzi błąd i alarmuje.
- Zbiór do pomiaru nie bierze udziału w poprawkach. Gdy przeczytasz jego pudła, przestaje być ślepy i potrzebujesz nowego.
- Kilkadziesiąt przypadków daje szeroki margines. Przy 21 przypadkach to około ±0,2. Różnica 0,48 do 0,90 jest większa niż ten szum, ale różnicy 3 punktów na takim zbiorze nie traktuj poważnie.
- Ocena zajmuje mniej czasu, niż się wydaje. 24 minuty za pierwszym razem, 7 minut za drugim.
Od czego zacząć z evalami w AI u siebie
Wybierz jeden krok AI, który podejmuje decyzję
Najlepiej taki, który wybiera z zamkniętej listy: etykieta maila, „pokaż albo pomiń”, kategoria zgłoszenia. Tam porównanie z kluczem to proste „zgadza się albo nie”.
Zbierz 30–40 prawdziwych przypadków
Z produkcji, z ostatnich tygodni. Nie wymyślaj ich i nie pozwól, żeby AI je za Ciebie oznaczyło.
Oceń je na ślepo
Bez odpowiedzi automatu przed oczami i w losowej kolejności. Przypadki, przy których się wahasz, oznacz „nie wiem” i odłóż.
Podziel zbiór na dwie części
Na jednej poprawiasz prompt, na drugiej tylko mierzysz. Wynik podajesz z tej drugiej.
Najpierw popraw opis zadania, potem porównuj modele
Sprawdź, czy prompt opisuje to, czego dziś naprawdę chcesz. Dopiero na dobrym prompcie porównaj dwa albo trzy modele.
Ustaw cotygodniowy przebieg i alarm
Alarm, gdy model zwraca błędy albo trafność spada. Wtedy wyłączony model wyjdzie w poniedziałek rano, a nie po sześciu tygodniach.
Koszt jest pomijalny. Nasze przebiegi kosztowały od 0,003 do 0,013 USD. Najdroższa część to Twoje pół godziny na ocenę przypadków.
Co to jest eval w AI?
Zestaw prawdziwych przypadków z odpowiedzią człowieka, przez który puszczasz krok AI i liczysz trafienia. Pozwala porównać prompty i modele liczbą, a nie wrażeniem, i wyłapać moment, w którym AI przestało działać.
Czy do evali potrzebuję Claude Code?
Nie. Komendy /claude-api build-eval i hillclimb są dla aplikacji pisanych w kodzie. Nasze evale działają w n8n na zwykłych węzłach. Claude przydaje się do napisania porównania i podsumowania wyników.
Czy evale w n8n wymagają płatnego planu?
Wbudowany eval z metrykami działa na darmowej wersji z własnym serwerem w jednym workflow. Lżejsza wersja z wynikami w tabeli działa wszędzie. My liczymy wynik sami zwykłymi węzłami, więc limit nas nie dotyczy.
Ile przypadków potrzeba do evala?
Na start 30–40. Anthropic poleca od 15 do 100. Mniej niż 15 i jeden niepewny przypadek przesuwa cały wynik.
Co, jeśli AI pisze tekst, a nie wybiera z listy?
Wtedy nie ma jednej dobrej odpowiedzi do porównania. Zamiast tego drugi model ocenia tekst według listy konkretnych pytań, na przykład „czy streszczenie nie zmyśla liczb”. To trudniejsze i warto zacząć od kroków, które wybierają z listy.
Czy mogę wrzucić do evala maile klientów?
To dane osobowe, więc najpierw sprawdź, czy wolno Ci je w ten sposób przetwarzać i gdzie będą leżeć. U nas maile na razie do tabel evalu nie trafiają. Automat od poczty ma tylko minimum: błąd modelu wychodzi jako błąd i wysyła alarm.