 Grzegorz Adamczyk
Effort w Claude to suwak, którym mówisz modelowi, ile pracy ma włożyć w odpowiedź: jak długo myśleć, ile plików przeczytać, ile razy sprawdzić wynik. Nie zmienia modelu, ale może zwiększyć jego skuteczność. W moim teście na fakturach i skanach wyłączenie myślenia kosztowało 23 pomyłki w kodach produktów na jednym rozmytym skanie, a już najniższy poziom effort zostawił ich 3–4. Medium i high nie poprawiły nic więcej, za to każdy dokument kosztował drożej. Te 3–4 pomyłki zostały jednak na każdym poziomie, więc effort nie zastępuje sprawdzania danych. Pokazuję, który poziom ustawić w Claude Code, w czacie, w API i w automacie n8n, i kiedy max tylko wydłuża czekanie.
Z tego artykułu dowiesz się:
- Czym jest effort i czym różni się od wyboru modelu i od przełącznika myślenia
- Jakie są poziomy (low, medium, high, xhigh, max) i który jest domyślny w Haiku 5.5, Sonnet 5.5, Opus 5.5 i Fable 5.1
- Ile kosztuje wyższy effort w czasie i tokenach, na liczbach Anthropic i na moim teście
- Kiedy podnieść effort, a kiedy zmienić model
- Gdzie go ustawić: Claude Code, aplikacja Claude, API i n8n przez OpenRouter
- Jak dawać różny effort subagentom i co znalazłem we własnych ustawieniach
W skrócie: szkic, szybkie pytanie, proste wyszukiwanie: low. Codzienna praca: domyślny poziom (w Opus 5.5 i Haiku 5.5 to medium). Zmiana w wielu plikach, przegląd, trudny błąd: high. Xhigh i max tylko wtedy, gdy własny test pokaże zysk. Pełna ściąga jest niżej.
Czym jest effort w Claude, a czym nie jest
Dokumentacja Anthropic opisuje effort jako sposób, żeby jednym modelem wybrać między dokładnością odpowiedzi a liczbą zużytych tokenów. Ważne są dwa szczegóły.
Po pierwsze, effort działa na całą odpowiedź, nie tylko na myślenie. Zmienia długość i liczbę rozważań, liczbę wywołań narzędzi, to, czy Claude zrobi plan przed działaniem, i to, jak szczegółowo podsumuje wynik. Lydia Hallie z Anthropic w artykule o wyborze modelu i effort w Claude Code (7.07.2026) wylicza wprost: effort decyduje także o tym, ile plików Claude przeczyta, ile sprawdzi i jak daleko przejdzie przez zadanie, zanim zapyta Cię o zdanie. Przy niskim effort Claude woli dopytać, niż samemu szukać.
Po drugie, to wskazówka, a nie limit. Dokumentacja effort nazywa go „behavioral signal, not a strict token budget”: na niskim poziomie Claude nadal myśli przy trudnym problemie, tylko mniej. Twardym limitem jest max_tokens, ale tylko dla jednego wywołania: ogranicza sumę tokenów myślenia i odpowiedzi. Nie ogranicza kosztu wejścia ani kolejnych wywołań w pętli agenta, więc nie jest limitem kosztu całego zadania.
Thariq Shihipar z Anthropic opisał to w tekście z 25.09.2026 analogią, która mi się najbardziej przydała. Jeśli ktoś da Ci zadanie na 12 godzin, zakładasz, że ma być zrobione porządnie do końca. Jeśli to samo zadanie dostajesz na godzinę, robisz najlepszą wersję, jaka się zmieści, i liczysz na poprawki w kolejnych rundach. Effort to właśnie ta liczba godzin.
Czym effort nie jest:
- To nie wybór modelu. Haiku, Sonnet, Opus i Fable to różne modele. Effort ustawia, ile czasu każdy z nich poświęci zadaniu.
- To nie przełącznik myślenia. Matt Bleifer, product manager w Anthropic, mówił na konferencji Code with Claude w maju 2026, że włączanie i wyłączanie myślenia to słaby zamiennik effort: „you're constraining how it's allowed to work, not how hard you want it to work”. Effort przesuwa razem myślenie, narzędzia i tekst odpowiedzi.
- To nie budżet tokenów. Starszy parametr
budget_tokensmówił, ile tokenów wolno wydać na myślenie. Od lutego 2026 na nowych modelach zastępuje go effort.
Pięć poziomów effort i ustawienia domyślne
Haiku 5.5, Sonnet 5.5, Opus 5.5 i Fable 5.1 mają po pięć poziomów: low, medium, high, xhigh i max. Domyślny poziom zależy od modelu i od miejsca, w którym z niego korzystasz (stan dokumentacji z 17.10.2026):
| Model | Domyślny w API | Domyślny w Claude Code | Czy da się wyłączyć myślenie w API |
|---|---|---|---|
| Haiku 5.5 | medium | medium | tak, przy high i niżej |
| Sonnet 5.5 | high | medium | nie |
| Opus 5.5 | medium | medium | nie |
| Fable 5.1 | high | high | nie |
Co znaczą poziomy według dokumentacji Anthropic:
- low: najoszczędniejszy, wyraźnie mniej tokenów za cenę części możliwości. Do prostszych zadań, w których liczy się szybkość i koszt, a dokumentacja wymienia tu wprost subagentów.
- medium: równowaga między szybkością, kosztem i jakością w zadaniach agentowych. Domyślny w Opus 5.5 i Haiku 5.5.
- high: tyle tokenów, ile zadanie potrzebuje do bardzo dobrego wyniku. Złożone rozumowanie, trudny kod, zadania agentowe. Domyślny w pozostałych modelach.
- xhigh: długie zadania agentowe i programistyczne, powyżej 30 minut, z budżetem tokenów w milionach.
- max: bez ograniczeń wydatku na tokeny, do zadań wymagających najgłębszej analizy. Dokumentacja Claude Code ostrzega, że max może dawać coraz mniejsze zyski i skłania model do przemyślania prostych rzeczy, więc warto go przetestować, zanim ustawisz go na stałe.
Dla Haiku 5.5 dokumentacja dodaje praktyczną uwagę: na low w długich poleceniach agentowych model częściej pomija wyszukiwanie, kończy za wcześnie albo nie robi sprawdzenia, a xhigh i max warto włączać tylko wtedy, gdy własny test pokaże zysk, i porównać je z Sonnet 5.5.
Jedna rzecz, o której łatwo zapomnieć: ten sam poziom znaczy co innego w każdym modelu. Anthropic kalibruje skalę osobno dla każdego modelu i podaje, że Opus 5.5 na medium dorównuje Opusowi 5 na high albo go przewyższa w testach programistycznych i pracy z wiedzą. Jeśli przeniosłeś ustawienia ze starszego modelu, prawdopodobnie przepłacasz.
Ile kosztuje wyższy effort: czas, tokeny i mój test
Czas: 1,5 minuty kontra 67 minut
Thariq dał Opusowi 5.5 to samo, słabo opisane zadanie („zbuduj aplikację do śledzenia treningów”) na różnych poziomach. Low skończył w 1,5 minuty, medium w 4, high w 11, max w 67. To nie były te same aplikacje: na low powstał prosty dziennik treningów z wykresem, na wyższych poziomach aplikacja była coraz bardziej rozbudowana, a na max doszła mapa cieplna. Porównujesz więc reakcję na to samo polecenie, nie czas zrobienia tego samego produktu. Kiedy zadanie dostało dokładną specyfikację, różnice zmalały: 16, 22, 33 i 79 minut. Na słabo opisanym zadaniu max pracował więc mniej więcej 45 razy dłużej niż low, na dobrze opisanym około 5 razy. Wniosek autora: przy dobrej specyfikacji modele na różnych poziomach zachowują się dużo podobniej.
Tokeny: kilkanaście razy więcej za kilkanaście punktów
Artificial Analysis mierzy każdy poziom osobno. Ich Intelligence Index i liczba tokenów wyjścia zużytych na cały pomiar (odczyt 17.10.2026 ze stron Haiku 5.5, Sonnet 5.5 i Opus 5.5; przy Sonnet i Opus serwis oznacza konfigurację dopiskiem „default fallback”):
| Model | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| Haiku 5.5 | 29 pkt / 32 mln | 34 / 54 mln | 38 / 97 mln | 41 / 180 mln | 43 / 440 mln |
| Sonnet 5.5 | 36 / 23 mln | 41 / 31 mln | 47 / 52 mln | 52 / 110 mln | 56 / 420 mln |
| Opus 5.5 | 42 / 20 mln | 51 / 38 mln | 54 / 53 mln | 56 / 100 mln | 58 / 260 mln |
Haiku 5.5 od low do max zyskuje 14 punktów, ale zużywa prawie 14 razy więcej tokenów. Opus 5.5 od domyślnego medium do max dokłada 7 punktów za blisko 7 razy więcej tokenów. Tempo generowania prawie się nie zmienia między poziomami, więc dłuższe czekanie to po prostu więcej tokenów, za które płacisz jak za tokeny wyjścia.
Mój test: 12 faktur i skanów na Haiku 5.5
W teście Haiku 5.5 na fakturach porównałem dwie skrajności: myślenie wyłączone i effort high. Dziś dorobiłem low i medium na tych samych 12 dokumentach, po dwie rundy, przez ten sam endpoint w UE. To 24 wykonania na każdą konfigurację (12 dokumentów razy 2 rundy), a nie 24 różne dokumenty, więc to test konkretnego zestawu, nie ogólna reguła dla wszystkich faktur i skanów. Pułapką był skan zamówienia drukowany czcionką 7,5 pt, na którym 23 kody produktów mają literę O obok cyfr (np. PA-805-O7).
| Haiku 5.5 | Pomyłki O/0 na skanie (runda 1 i 2) | Dokumenty bez błędów | Koszt na dokument | Średni czas |
|---|---|---|---|---|
| bez myślenia | 23 i 23 | 22 z 24 | 0,0020 USD | 8,2 s |
| effort low | 4 i 3 | 22 z 24 | 0,0028 USD | 12,6 s |
| effort medium | 4 i 3 | 22 z 24 | 0,0029 USD | 13,1 s |
| effort high | 3 i 4 | 22 z 24 | 0,0031 USD | 14,4 s |
Bez myślenia Haiku 5.5 zamienił literę O na zero we wszystkich 23 kodach, w obu rundach. Każdy poziom z myśleniem zostawił 3–4 pomyłki, i to zawsze w tych samych pozycjach. Między low a high różnica była tylko w rachunku: na rozmytym skanie high myślał średnio dwa razy dłużej (około 3000 tokenów rozumowania wobec 1500 na low), a koszt dokumentu wzrósł o 53% wobec wersji bez myślenia, przy 39% na low (procenty policzone przed zaokrągleniem kwot w tabeli). Na czystych, cyfrowych PDF-ach żaden poziom nie zmienił wyniku: wszystkie konfiguracje odczytały je bezbłędnie.
To ta sama zasada, którą Thariq opisuje dla dużych zadań, tylko w automacie za ułamek centa: effort pomaga tam, gdzie jest ukryty przypadek brzegowy. Tam, gdzie go nie ma, zwykle tylko zwiększa zużycie. Na moim zestawie low dał taki sam wynik jak high przy niższym koszcie. Nadal zostawiał jednak 3–4 błędy w kodach, a dokumentów bez błędów było 22 z 24 w każdej konfiguracji, więc effort nie zastępuje walidacji danych w automacie.
Podnieść effort czy zmienić model?
Lydia Hallie podaje prosty test. Jeśli Claude miał cały potrzebny kontekst, wyraźnie próbował i nadal się pomylił, weź mocniejszy model. Jeśli pomylił się, bo pominął plik, nie uruchomił testów albo porzucił refaktoryzację w połowie, podnieś effort. Zanim ruszysz którekolwiek pokrętło, sprawdź jednak, jaki kontekst dałeś, bo to najczęstsza przyczyna złej odpowiedzi.
Wewnętrzne przebiegi Anthropic na Terminal-Bench 3.0, które Thariq pokazał we wpisie, mówią to samo liczbami. Fable 5.1 na max zaliczył 214 z 370 prób, a na low 140. Wyższy effort prawie trzy razy rzadziej przepuszczał błąd, którego nie złapały testy (14 wobec 40 przypadków). Za to częściej wybierał niewłaściwą interpretację zadania (47 wobec 25), choć rzadziej błędnie odczytywał konkretne wymaganie (26 wobec 45). Rodzaje błędów przypisywał model oceniający, więc autor zaznacza, że są przybliżone. Autor podsumowuje, że wyższy effort ogranicza pominięte przypadki brzegowe, ale nie naprawia złego podejścia. Te liczby pochodzą z wewnętrznych przebiegów Anthropic, po 5 prób na zadanie, i nie zgadzają się z publicznym rankingiem.
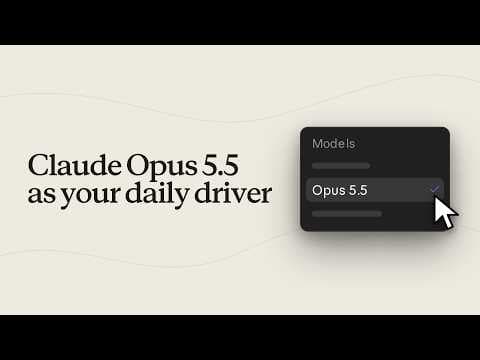
Dobrze to widać na nagraniu z kanału Claude. Opus 5.5 na medium zmienia nazwę pola w jednym pliku i testy przechodzą, ale nie zauważa, że aplikacja mobilna wysyła to samo pole pod inną nazwą. Na high śledzi, co wysyła to pole, poprawia też klienta mobilnego i serializer, a na koniec dopisuje test. Prowadząca mówi wprost, że na co dzień pracuje na medium, a high włącza przy zmianie w wielu plikach naraz.
Gdzie ustawić effort: Claude Code, aplikacja, API i n8n
Claude Code
/effortotwiera suwak;/effort low…/effort maxustawia poziom od razu,/effort autowraca do domyślnego. Poziom zmienisz też w/modelstrzałkami w lewo i w prawo.claude --effort highustawia poziom na jedną sesję.- Zmienna
CLAUDE_CODE_EFFORT_LEVELma pierwszeństwo przed wszystkim innym. Tylko przez nią max zostaje na stałe: wybrany suwakiem działa wyłącznie w bieżącej sesji. - Ustawienia per model (
modelSettings.<model>.effortLevelwsettings.json) pamiętają osobny poziom dla każdego modelu.maxEffortLevelobcina wszystko powyżej wskazanego poziomu, także w skillach i subagentach. - Pole
effortwe frontmatterze skilla albo subagenta nadpisuje poziom sesji na czas jego pracy. ultrathinkw treści polecenia daje głębsze rozumowanie na jedną turę, bez zmiany ustawionego poziomu.- Ultracode to nie poziom effort, choć tak bywa opisywany na forach. To przełącznik w suwaku
/effort, przy którym Claude planuje większe przebiegi z wieloma subagentami.
Aplikacja Claude
W czacie kliknij nazwę modelu obok przycisku wysyłania, wybierz „Effort” i poziom. Domyślny jest oznaczony etykietą „Default”, a zmiana działa od następnej odpowiedzi. Pomoc Anthropic uprzedza, że wyższy effort daje dokładniejsze odpowiedzi, ale trwa dłużej i szybciej zużywa limit. Myślenia w Haiku 5.5, Sonnet 5.5, Opus 5.5 i Fable 5.1 w aplikacji nie wyłączysz.
API
Effort ustawiasz w output_config, na przykład "output_config": {"effort": "low"}. Ustawienie wartości domyślnej daje dokładnie to samo co brak pola. Zmiana effort między żądaniami unieważnia cache promptu, chyba że korzystasz z bety zmiany effort w trakcie rozmowy, którą dokumentacja opisuje dla Opus 5.5, Sonnet 5.5, Haiku 5.5 i Fable 5.1.
n8n przez OpenRouter
W OpenRouterze poziom idzie w reasoning.effort. U mnie automaty wołają modele przez węzeł HTTP Request z jawnym body, opisałem to w tekście o routerze modeli w n8n. Tu złapałem jedyną naprawdę kosztowną pułapkę w całym temacie. Wartość none (myślenie wyłączone) działa na Haiku 5.5, ale na Sonnet 5.5 i Opus 5.5 kończy się błędem 400 „Reasoning is mandatory for this endpoint and cannot be disabled”. Zmierzyłem to 29.09.2026, kiedy przełączałem łańcuch pisania artykułów na Sonnet 5.5. W moim teście tego żądania zapasowe modele z listy się nie uruchomiły, więc sama zmiana modelu bez zmiany none wywróciłaby każdą sekcję. To wynik jednej konfiguracji, nie reguła dla każdego błędu 400: dokumentacja OpenRoutera dopuszcza przejście na zapasowy model po różnych błędach. Szczegóły tamtego przejścia są w tekście o Sonnet 5.5.
Subagenci: szukający nisko, sprawdzający wysoko
W Claude Code główna sesja często rozdziela pracę na subagentów: jeden przeszukuje kod, drugi czyta dokumentację, trzeci sprawdza wynik. Od wersji 2.1.292 każdemu z nich możesz dać inny effort zwykłym zdaniem w poleceniu. Anthropic w newsletterze z 17.10.2026 podaje taki przykład:
„Find every payments API call with low effort subagents, then have a high effort one check the error handling”
Po polsku: znajdź każde wywołanie API płatności subagentami na low, a potem niech jeden na high sprawdzi obsługę błędów. Wcześniej trzeba było wpisać pole effort w pliku definicji subagenta. Tak samo możesz poprosić o konkretny model, na przykład Haiku do szybkiego szukania. Jeśli ustawisz zmienną CLAUDE_CODE_EFFORT_LEVEL, wygrywa ona i z poleceniem, i z plikiem.
W tym samym newsletterze zespół Anthropic zdradza, że subagenci domyślnie stawiają na dokładność, a nie na tempo. Jedno zdanie dopisane do polecenia zmienia to, jak się rozpędzają: „Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better.” Według zespołu to sformułowanie dawało najlepszą równowagę między szybkością a jakością spośród kilku, które sprawdzali.
Przy okazji tego tekstu przejrzałem własne ustawienia. Na co dzień pracuję w Claude Code na Opus 5.5 z zapisanym high, czyli poziom nad domyślnym. Mam 15 własnych subagentów i żaden nie ma pola effort, więc wszystkie dziedziczą high, także te, które tylko przeszukują pliki. W ustawieniach znalazłem też klucz effortLevel: xhigh na poziomie całego pliku. Według dokumentacji ten klucz w pliku użytkownika nie działa na Opus 5.5 i nowszych modelach. Wyglądał na ustawienie, a niczego nie ustawiał.
Który poziom effort do czego: ściąga
Poniższa tabela łączy zasady Thariqa, zalecenia z dokumentacji i mój test.
| Zadanie | Poziom | Dlaczego |
|---|---|---|
| Burza mózgów, szkic, prosta zmiana, gdy chcesz być w pętli | low | szybka odpowiedź, Claude dopyta zamiast zgadywać |
| Odczyt faktur i dokumentów w automacie (Haiku 5.5) | low | w moim teście low dał ten sam wynik co high, o 9% taniej; dane i tak sprawdzaj |
| Codzienna praca w Claude Code, nowa funkcja | medium | domyślny w Opus 5.5; Thariq używa go do większości pracy |
| Błąd w starym kodzie, zmiana w wielu plikach, przegląd | high | liczy się sprawdzenie i przypadki brzegowe |
| Długa samodzielna praca, szukanie luk bezpieczeństwa | xhigh albo max | tylko gdy test pokazuje zysk; max potrafi przemyśleć proste rzeczy |
| Subagent, który tylko szuka w plikach | low | proste wyszukiwanie po znanych frazach |
| Subagent, który sprawdza wynik innych | high | to on ma złapać to, co pominęli |
Thariq na X napisał to jeszcze krócej (25.09.2026): low używa, kiedy chce zostać w pętli, a max „basically only if I want zero input or want to find security vulnerabilities”.
Podsumowanie
Effort mówi Claude'owi, ile czasu ma poświęcić zadaniu. Nie zmienia modelu, ale może zwiększyć jego skuteczność. Pomaga tam, gdzie są ukryte przypadki brzegowe: pominięty plik, nieuruchomiony test, litera O wśród cyfr. Tam, gdzie ich nie ma, zwykle tylko wydłuża czekanie i podnosi rachunek. W moim teście dokumentów różnicę zrobiło włączenie myślenia, a nie wysoki poziom: low dał ten sam wynik co high, a high kosztował więcej. Kilka pomyłek zostało na każdym poziomie, więc kontrola danych w automacie dalej jest potrzebna.
Domyślne poziomy są dziś rozsądne, a ten sam poziom w nowszym modelu daje więcej niż w starszym, więc warto zacząć od domyślnego i podnosić go tylko wtedy, gdy widzisz konkretny błąd. Jak radzą sobie same modele, sprawdzałem w tekstach o Opus 5.5, Sonnet 5.5 i Haiku 5.5. Jak zmieniać działanie samego Claude Code, pokazałem w tekście o modach w Claude Code. Starszy tekst o Claude Sonnet 5 dla małej firmy opisywał effort głównie jako czas myślenia; ten tekst go uzupełnia.
Nowe modele i narzędzia AI zbieram też w newsletterze: co dwa tygodnie, zawsze z cytatem i źródłem. Zapis jest na dole strony.
Czy max effort zawsze daje najlepszy wynik?
Nie. Max daje najwięcej czasu na rozumowanie, ale Anthropic ostrzega przed malejącymi zyskami i przemyśleniem prostych zadań. W teście Thariqa max pracował 67 minut tam, gdzie low skończył w 1,5 minuty, choć max zbudował bardziej rozbudowaną aplikację. W moim teście dokumentów high nie poprawił nic względem low.
Czym effort różni się od extended thinking?
Przełącznik myślenia mówi tylko, czy Claude ma myśleć przed odpowiedzią. Effort ustawia, ile pracy Claude włoży w całą odpowiedź: w myślenie, w liczbę wywołań narzędzi i w sam tekst. W nowych modelach z myśleniem adaptacyjnym Anthropic zaleca sterować głębokością myślenia właśnie przez effort.
Czy wystarczy napisać w poleceniu „nie myśl za długo”?
Nie zawsze. Dokumentacja podaje, że w Haiku 5.5 taka prośba nie zmniejsza myślenia niezawodnie. Pewniejszą drogą jest zmiana poziomu effort.
Czy zmiana effort w trakcie pracy psuje cache?
W API zmiana effort między żądaniami unieważnia cache promptu, chyba że używasz bety zmiany effort w trakcie rozmowy. W Claude Code od wersji 2.1.280 zmiana effort w trakcie sesji na Opus 5.5 nie psuje cache (Lydia Hallie, 22.09.2026).
Ile limitu zjada wyższy effort w abonamencie?
Anthropic nie podaje mnożnika. Pomoc mówi tylko, że wyższy effort szybciej zużywa limity. Od wersji 2.1.299 polecenie /usage w Claude Code ostrzega, gdy pracujesz na max.
Czy ultracode to najwyższy poziom effort?
Nie. Ultracode to osobny przełącznik w suwaku /effort, przy którym Claude planuje rozbudowane przebiegi z wieloma subagentami. Poziom effort ustawiasz niezależnie od niego.
Dlaczego mój automat w n8n zwraca błąd 400 po zmianie modelu na Sonnet 5.5?
Najczęściej przez reasoning.effort: none. Sonnet 5.5 i Opus 5.5 nie pozwalają wyłączyć myślenia, więc OpenRouter odrzuca takie żądanie. Ustaw low albo usuń parametr. Haiku 5.5 przyjmuje none.